Alex Zhang,2026 年 9 月 26 日。
关于语言模型“形状”的一些简短想法:围绕执行框架(harness)来设计语言模型,而不是反过来,这究竟意味着什么?
自从 ChatGPT 发布以来,我观察到语言模型的输入 / 输出形状大致没有变化。一个合理猜测是:用户总会希望使用当前最好的模型;而前沿模型实验室也不愿偏离已经被证明有效的模型形状,因为押注替代方案的成本非常高。因此,围绕设计语言智能体的所有工作,都是在设计一种能适配语言模型自回归形状的执行框架(harness)1。这个想法在多数人看来或许有些可笑,但我感兴趣的一个自然问题是:是否值得考虑反过来改变语言模型的形状,让它去适配执行框架?
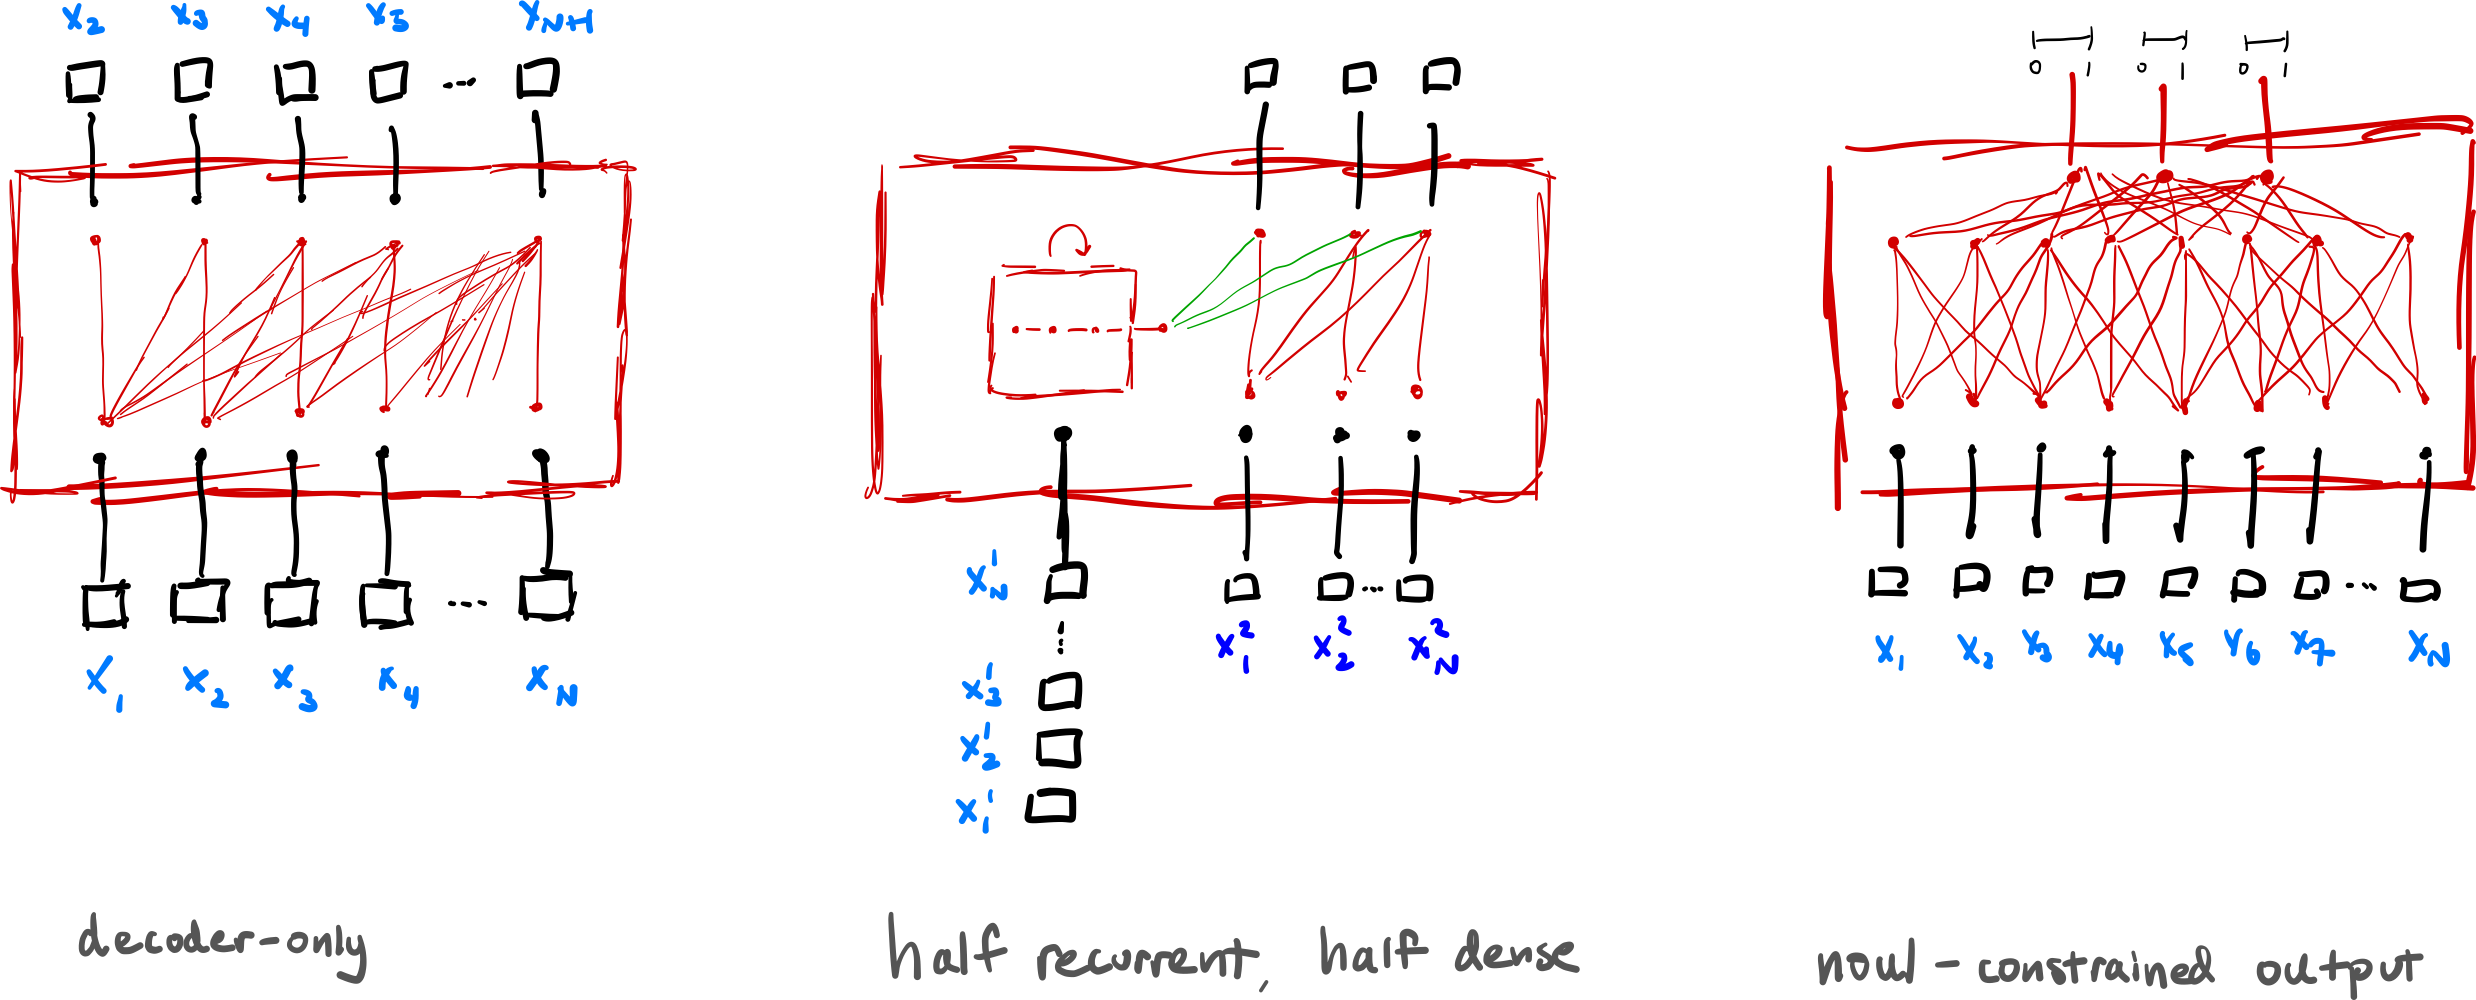
这条研究路线属于“模型架构研究”,但现代模型架构研究主要关注更大模型中各层的排列顺序和性质等细节,而模型整体仍是仅解码器 Transformer。原因很清楚:1)仅解码器语言模型极其强大且灵活;2)在规模化过程中,明智的模型架构选择价值数百万美元;3)稠密的 next-token prediction 是任意文本上的自然目标。这个领域也确实还有相当多的研究可做,因此它成为前沿实验室的关注中心是合理的。2
几年前,我曾非常期待 State-Space Models(SSM,状态空间模型)和 Mamba 这类新型循环架构的潜力;但看到它们大多被用于仍保留仅解码器 Transformer 形状的混合模型时,我相当失望。我甚至觉得,“混合”在这里指的是注意力层与 SSM 层在纵向交错堆叠,而不是让它们作用于平行的残差流,这一点尤其有意思!我相信,之所以最终形成这种选择,背后有许多经验性原因。3 不过我想说的是:这些层具有不同于 Transformer 的性质,或许能在执行框架中得到更多利用。所有仅解码器 Transformer 都假定“任意文本 → 任意文本”的形状;但如果我们能对所用模型的输入 / 输出形状作出一些结构性假设呢?
我所说的一个绝佳例子,是本月早些时候发布的 Jev(Typesafe AI,2026)。它可以被看作一种语言模型,其输出空间被显式约束为 (\mathbb{R}_{[0,1]})。这个约束使模型在采样时可以只做预填充(prefill-only),从而能极快地回答某一类特定问题。无论你怎么看这种构造的实用性或有效性,4 Jev 所代表的都是围绕语言模型形状的一种替代权衡空间。在非常特定的用例中,你很可能会更愿意选择 Jev 而不是前沿模型;甚至可能存在一些执行框架设计会让它变得有用。举例来说,我见过有人把它作为快速条件预测工具,用来实现模糊的 if 语句逻辑;这对 Recursive Language Model(RLM) 执行框架实际上很有用。Jev 特别提出了一个新的目标函数,称为用于校准决策的强化学习(Reinforcement Learning for Calibrated Decisions,RLCD;至少写作时它仍是秘密),我猜想,对于其他输入 / 输出形状,我们也必须提出经修改的目标函数,才能真正为正确行为进行优化。
这个方向尤其令我兴奋,因为它比一味扩大规模更有原则,也需要更多创造力!你很可能需要利用自己对某一类问题结构的直觉或发现,来设计和训练定制化的模型形状,使它比前沿模型更具成本效益。
智能体中的语言模型形状
我的一个“热门观点”是:我不认为仅解码器 Transformer 是处理智能体轨迹的自然形式,或最终形式;这也是 compaction 这类上下文管理技巧之所以存在的原因。5 在 LLM 时代,智能体通常是 ReAct(Yao 等,2022) 的变体,它们会随时间累积上下文。每一轮中,智能体 (\pi_{\theta}) 产生一个动作 (a_t)(例如推理 + 工具调用);这个动作会带来一个观察 (o_t),并被追加到轨迹中。智能体轨迹通常形如:
[a_{t+1} \sim \pi_{\theta}(\cdot | \mathcal{H_{<t}}, o_t) \qquad \mathcal{H}_{<t} = (P, a_1, o_1, a_2,o_2,...,a_t)]
语言模型的“仅解码器 Transformer”形状,给出了我们在语言智能体中习以为常的形式:直接把 (\mathcal{H}{<t}) 和 (o_t) 当作上下文中的 token 序列传入。这个设置有两个众所周知的问题:1)模型的上下文窗口有限,因此智能体历史 (\mathcal{H}{<t}) 最终必须被压缩;2)相较于较早的历史,我们对近期观察的重视程度并不相同,而我们希望以历史为条件,却未必需要对每个 token 都做稠密注意力。
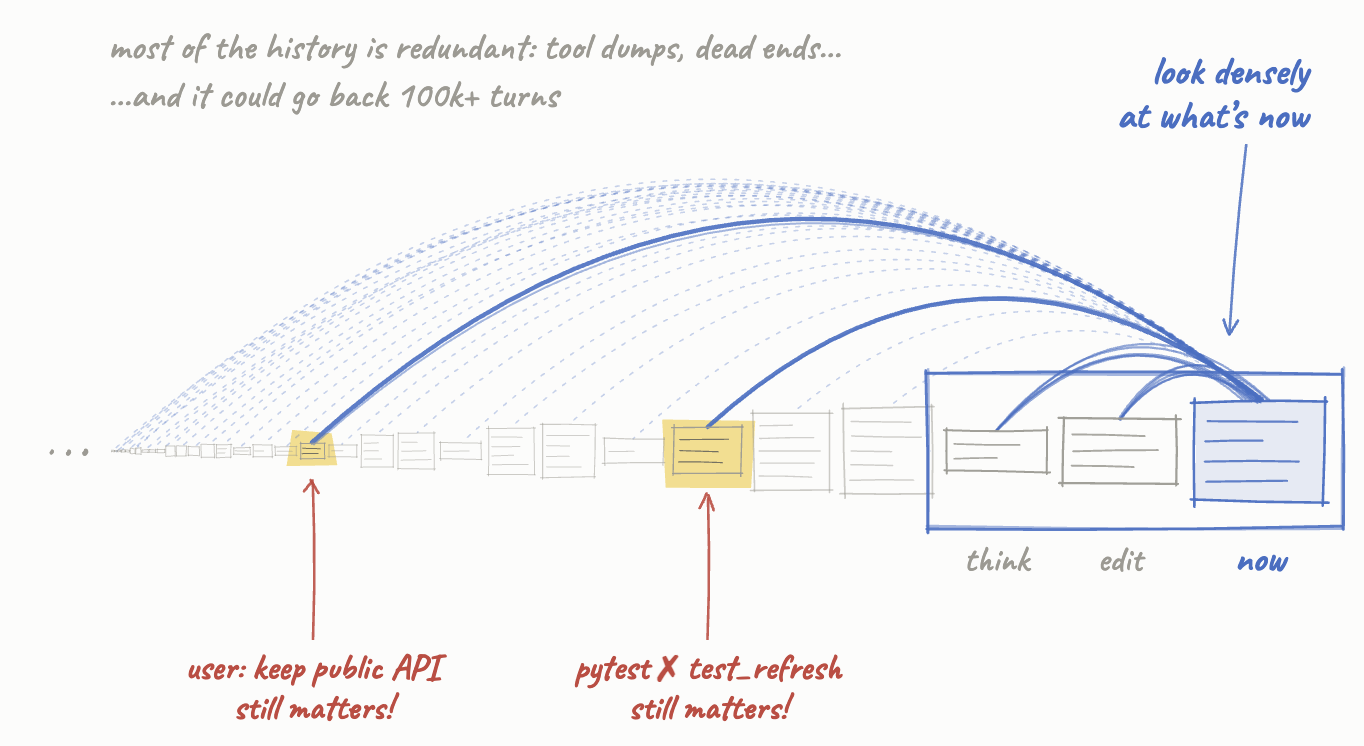
你可以认为,稀疏注意力模式或线性注意力方法(例如 Gated DeltaNet)部分解决了这个问题;但这些方法往往仍会与同一残差流上的至少一个全局注意力层交错使用,而那条残差流代表着完整上下文。多年来,人们已经用基础语言模型做出了若干近似这种“无限上下文”理想行为的技巧,例如 StreamingLLM(2023);但我认为,它们想覆盖的任务范围过于宽泛,以至于相较于不用它们并没有真正意义。尤其对智能体问题而言,我们可以对观察、工具调用和动作的重要性随时间衰减的结构作出更强的假设,并直接把它融入模型形状。我们也知道,语言智能体不必从历史中完美检索事实(这是非稠密注意力层的常见问题);有了这种新的语言模型形状后,智能体只需对部分信息获得粗略视图,就足以把真正的信息重新检索回工作上下文。
考虑到前沿实验室的激励机制,这条研究路线或许基本没有吸引力;但我确实相信,对独立研究者和学术界而言,试验新颖的语言模型形状,可能会带来既有用又极其高效的语言模型应用,而不受诸如 GPT-6 Astra 系统局限的阻碍。我认为我们正处在一个特殊的时期,这类研究甚至成为可能,下文会解释原因。
那些可能不再是挑战的“挑战”
回到 2022 年,甚至坦白说,回到 2026 年初,我都会说围绕“语言模型形状”的研究理由很弱,因为我们当时仍不确定语言模型本身的有效性与能力。最流行的语言模型任务是单轮问答任务,我们主要仍在关心:超人类的锯齿状智能,或者长上下文,能否通过任意形状的语言模型的规模化来实现。但现在我们知道这是真的。6 而在开放领域,我们拥有大量环境、数据和训练配方,可以逼近这些前沿模型的能力。
改变语言模型形状是否会真正提升模型的智能,很难确切判断;这也是为什么我们需要先走到今天,才能让这项研究成为更可行的方向。我唯一想提出的论点是,能够支持有意义组合的架构选择,可能会提高“每单位数据 / 环境所获得的智能”;不过总体而言,我们关心的是模型形状是否能为某些任务或执行框架带来更好的权衡。以 Jev 为例,它在智能程度上并没有显著超过任何前沿模型,但仍很可能在模糊决策任务中变得格外有用。
把仅解码器 Transformer 的能力蒸馏到其他语言模型形状中,或是在经过修改的仅解码器语言模型上引入新目标函数,都比以往任何时候更容易。我们已经在以相当宽松的方式做类似的事:把语言模型 + 执行框架的能力,蒸馏到单独的语言模型中。探索这一设计空间,也会明确鼓励开放模型作为工作的起点、新的基础设施来支持训练和推理新的语言模型形状,以及更多有趣但不循规蹈矩的系统工作。
有一些小实验我非常期待在将来分享,但我也很想看看其他研究者最终会在这个方向发现什么。如果你对这个方向有酷点子,也想聊聊,我的 私信 和收件箱始终开放。
如需引用:
@article{zhang2026shape,
  title   = "Language Model \"Shape\"",
  author  = "Zhang, Alex",
  year    = "2026",
  month   = "September",
  url     = "https://alexzhang13.github.io/blog/2026/shape/"
}
执行框架只是某种调用语言模型、以帮助解决更大任务的程序或代码。例如,通常你不能只把一项软件工程任务交给基础语言模型,然后期待它自行完成;你必须编写一个执行框架,让它进入循环、给它 grep 工具、给它与终端交互的方式,等等。↩
对不在前沿实验室的人(例如学术界)来说,这条研究路线几乎不可能开展。↩
我对这些选择如何做出的理解相当有限:大概是在这些拥有大量人员与算力的大型实验室里,先以近乎“散弹枪式”的方式并行尝试各种探索;有效的方案会被保留、扩散到其他实验室,最终进入开放领域。如果我所谈论的许多东西过去已在其中某家实验室以某种形式被探索过,我一点也不会惊讶;但很可能由于某些原因,它们没有继续走远。这也正是研究替代性押注如此有趣的地方!↩
尽管我认为它经常被误用或误述——许多令人兴奋的想法往往如此。Jev 不是能应对任何问题的神谕式分类器,也不只是一个简单的分类器。↩
实际上,我认为这对语言模型的许多其他应用也成立。但“智能体”已经变得无处不在且日趋标准化,因此值得思考:插入智能体执行框架中的语言模型,是否还能有其他可取的权衡。↩
Navier–Stokes 公告令我非常震惊——我承认,最初相关传闻出现时,我以为它们是假的(不过我想,那时它们确实还不是真的)。不久之后,Astra 能够在 NetHack 中 ascension 的结果同样令我震惊,尽管对很多人来说它也许没那么有趣。这些模型现在已经非常强大。↩