我们最新的 Claude 模型有个很好的特性:它们能根据投入强度(effort)调整表现,又不会破坏 Claude Code 的提示词缓存。不过很多用户都问过我:投入强度究竟是什么?什么时候该选哪个等级?我们为什么需要它?
为回答这些问题,我深入研究了评测,并在日常工作中亲自测试了不同投入强度的表现。
注:这篇文章提供了更多交互式图表和说明,见 https://claude.dev/blog/spending-your-effort/
总体而言,我发现投入强度是一种很好的控制方式:它能改变 Claude 进行验证和边界情况测试的程度,以及它自主运用判断的程度。
当硬件、代码审查和安全这类任务特别需要验证和边界情况测试时,增加投入能带来更好的结果。
但低投入和中等投入非常适合快速完成事情,同时保持你与 Claude 的协作节奏。
对于常规软件工程工作,我现在采用这样的循环:先让模型访谈我,再以低/中等投入实现,审查它构建的内容,最后以高投入进行验证。
什么是投入强度?
从宏观上说,投入强度让你可以近似指定模型在任务上花费多少计算量。它在某种程度上也对应你对任务难度的判断。
可以这样理解:如果有人让你连续做一件事 12 小时,你会觉得对方就是希望你全力完成它;如果对方让你在 1 小时内完成同样的任务,你会尽力交付一个满足需求的最好版本,并预期之后还要继续迭代。
或者,你也可能提出异议:这个任务至少需要 3 小时,然后花 3 小时把它交付出来。
看待投入强度也应该如此。Claude 总会合理地尝试完成你的任务,但更高的投入会让 Claude 在判断和验证时采取更多自主行动。
投入曲线
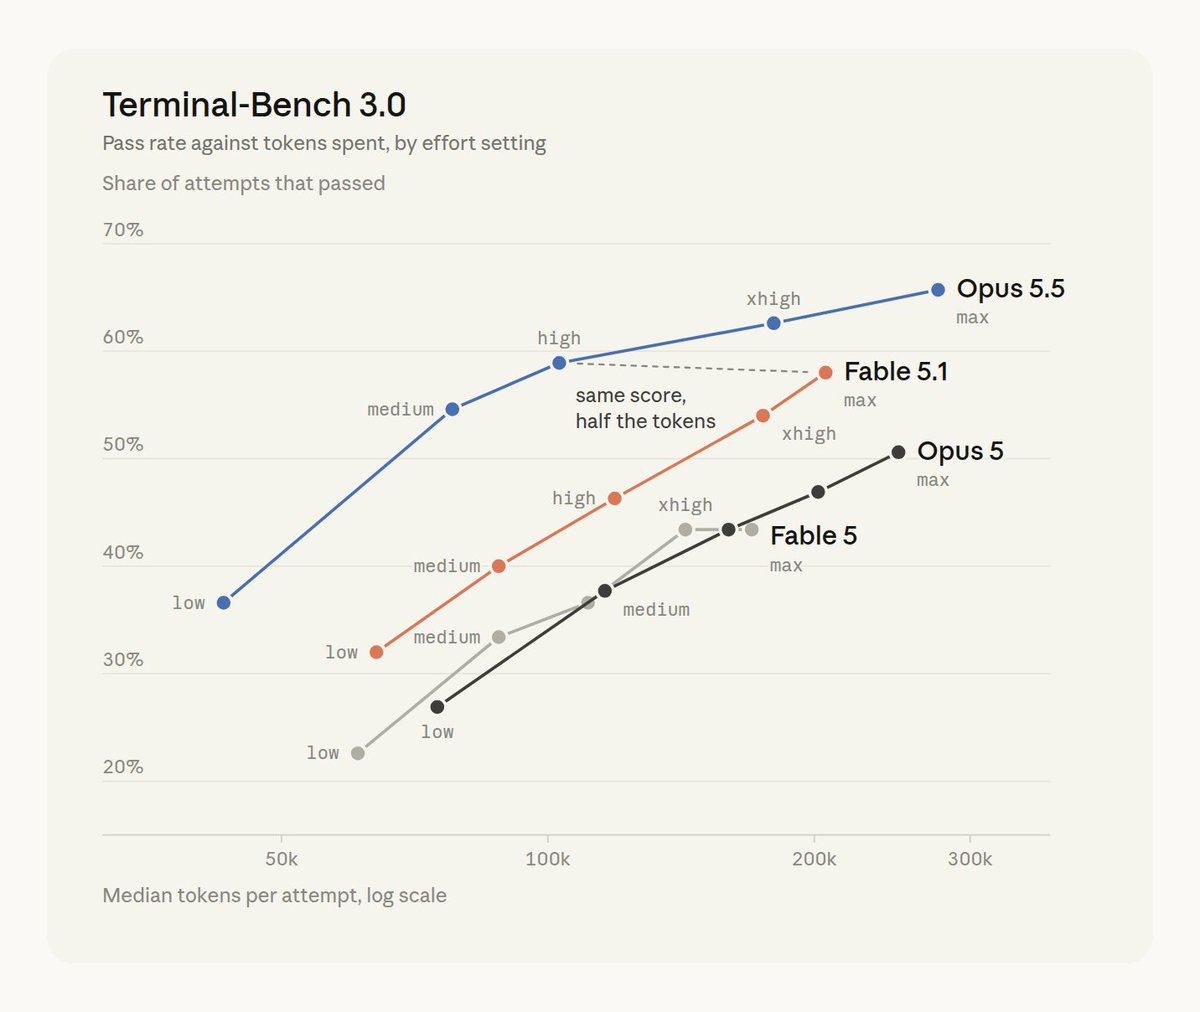
Fable 5.1 和 Opus 5.5 的投入曲线是我们迄今最好的:随着等级提升,基准分数和 token 消耗都会上升。下图是我为本文运行评测时,按投入强度统计的 Terminal Bench 3.0 得分。
但这在实际中意味着什么?为评估这一点,我让模型以不同投入等级完成了几项任务,也仔细研读了基准测试。
用投入强度构建
理解模型如何工作的最好办法是做实验。我让 Opus 5.5 在不同投入等级下完成相同任务,观察它会做出怎样的工作。这覆盖了许多类型的工作,下面用几个玩具示例来说明。
规格不完整的构建任务
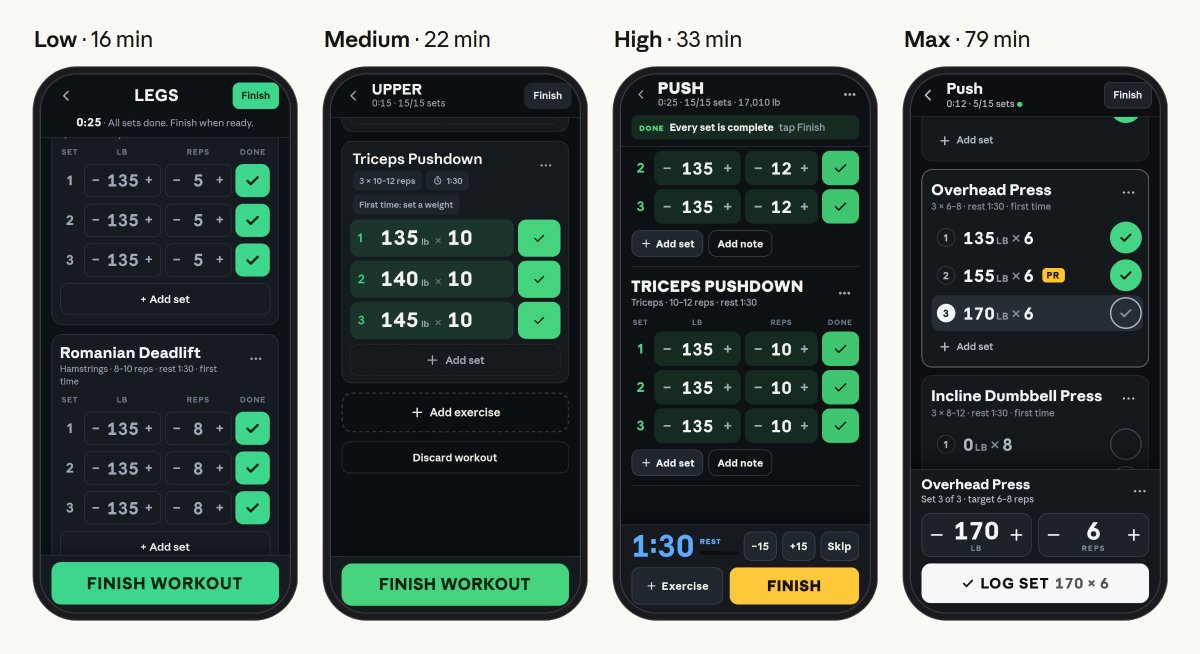
如果我让 Claude“构建一个个人健身与训练追踪应用”,投入强度会显著改变应用的完整程度,也会让 Claude 在过程中做出更多选择。低投入时,这个健身应用只有日志和简单图表;投入更高时,应用更复杂、细节更多;最高投入时则有热力图。
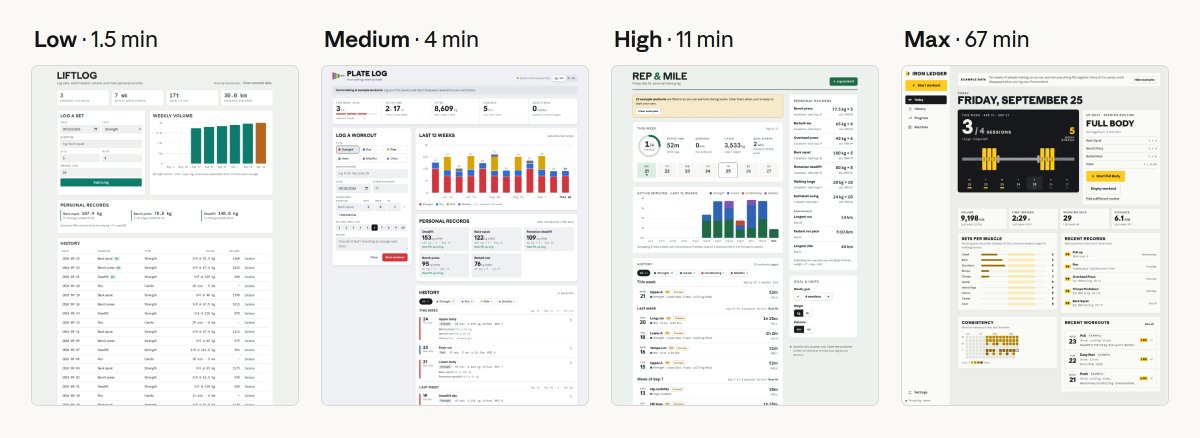
如果我只想获得一个可继续迭代的简单基础,低投入就足够。若我想一次性得到 Claude 能做出的最好结果,才会选择最高投入。
规格较明确的设计任务
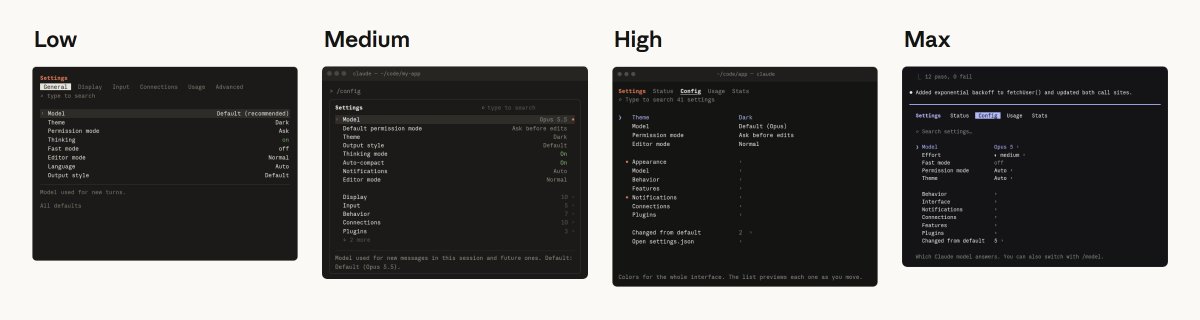
如果任务已经有相当明确的规格,但我还想和 Claude 一起探索呢?例如,我让它重新设计 Claude Code 的 /config 菜单。每一轮的核心思路大致相同:使用子菜单和更好的搜索。
低投入时(耗时 1 分钟),我得到了一张传达想法的交互式草图,但它看起来不太像 Claude Code。
最高投入时(耗时 28 分钟),我得到了一张非常接近 Claude Code 的 mockup,以及许多不同流程的演示说明。
如果我的目标是迭代并给出反馈,低投入能快得多地到达那个阶段。但最高投入从一开始就会给我更精致的成果。对这个特定任务,我更倾向于用低投入来理解 Claude 的构想。
规格非常明确的构建任务
如果我给 Claude 很多细节会怎样?我让 Claude 深入访谈我关于健身应用的需求,再把这份规格交给不同模型,以不同投入等级实现。
我发现,有了这份规格后,模型的行为会更加相似。得到的设计外观和实现大致相同,只是在细节上不同;最高投入时,Claude 会花些时间简化部分细节。
要点
对常规软件工程,尤其是新功能开发,选择哪一级投入很大程度取决于我希望自己参与到什么程度。低投入让 Claude 快速给出起点;更高投入会完成更多工作,但 Claude 也会替我做出更多假设。
我一直在使用、且对功能开发特别有效的循环是:
- 给 Claude 一份规格,让它访谈我遗漏的细节
- 以低投入实现
- 审查它是否抓住了核心;必要时继续以低投入迭代
- 以高投入验证和测试
投入等级如何影响困难任务的输出
但前面的显然都是 Claude 很能胜任的玩具示例。如果差别在于 Claude 能不能完成任务呢?
要找到这类困难问题,需要看基准测试。因此我深入研究了一个我喜欢的基准:由社区贡献的 Terminal Bench 3。
Terminal-Bench 3.0 的题目大致可分为安全、硬件、机器学习、科学、软件、运维和媒体等类别。你可以在这里查看所有题目:https://github.com/harbor-framework/terminal-bench/releases/tag/v3.0.0。它们来自社区,任何人都可以贡献。
很值得读一读,以了解这些模型面对的问题类型。我发现其中许多任务的范围和雄心都令我意外,它们比我通常面对的任务复杂得多。
例如,部分任务包括:
- 硬件(retro-console-soc):构建一台适配小型 FPGA、并能渲染测试 ROM 的 8 位游戏主机。
- 科学(takens-embedding-lean):在 Lean 4 中形式化证明 Takens 嵌入定理。
- 机器学习(mp-checkpoint-consolidation):将一个 mixture-of-experts checkpoint 的 16 个分片合并为一个文件,并复现参考 logits。
- 运维(intrastat-meldung):端到端完成一家公司的月末欧盟贸易统计申报。
- 媒体(layout-config-recreation):将一张海报图像重建为可编辑的布局文件。
边界情况很多时,更高投入更有帮助
阅读 Terminal Bench 3 的结果后,我最大的收获是:当任务隐藏着许多边界情况时,更高投入最有价值。
一个清晰的例子是 html-js-filter:这是 Terminal-Bench 3.0 的一道题,要求实现一个 HTML sanitizer,去除将 JavaScript 偷渡进页面的每一种方法。Fable 5.1 的成绩从低投入的 1/5 提升到 xhigh 的 5/5。
典型的低投入尝试大约需要 2 分钟。每次尝试大致都一次性写出过滤器,然后只用一个手写页面测试。
一次高投入运行约在 33 分钟后完成。在我跟踪的这次运行中,它先以对抗性方式审查初稿,接着阅读已安装 parser 的源码检查 bug,运行大量干净测试用例以确认输出与输入相同,运行标准 XSS 测试套件,最后还写了一个随机文档 fuzzer。
对于像 HTML sanitizer 这样边界情况极多的任务,这些额外投入非常值得。对于性能优化或安全审查等生产要求很高的复杂任务,多花 token 做彻底验证也合理。
但并不是每个任务都需要这个等级的投入。
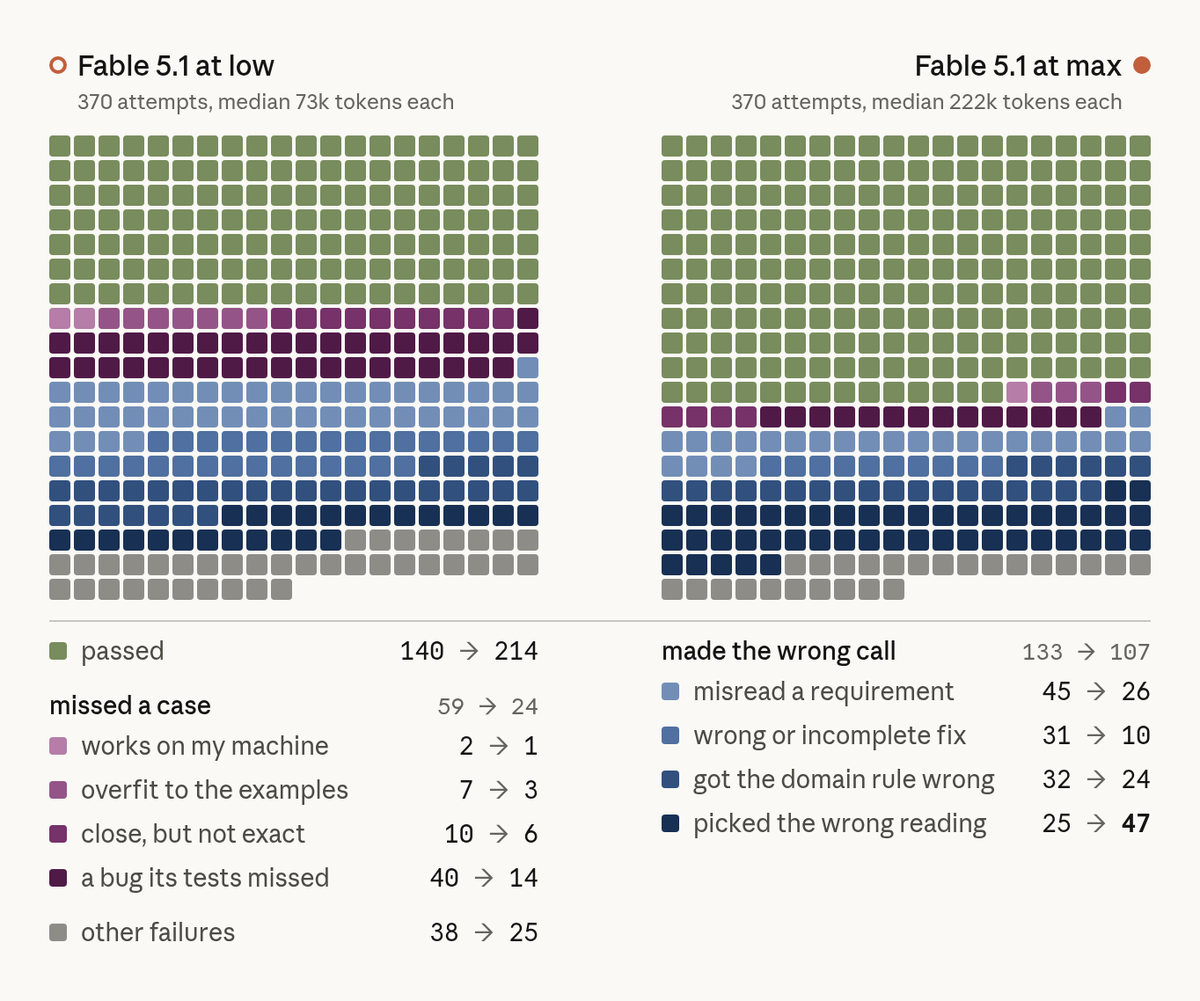
下图展示了 Terminal-Bench 3.0 的每项结果及其失败方式,涵盖不同模型和投入等级。总体上,增加投入倾向于减少因遗漏边界情况造成的失败(紫色方块),但无法修复模型采用了错误方法的情形(蓝色方块)。
投入特别有帮助的问题领域
我在 TerminalBench 上评估这些模型时,最有意思的发现之一是:有些问题领域比其他领域更能从投入中获益。下图给出了拆分结果:
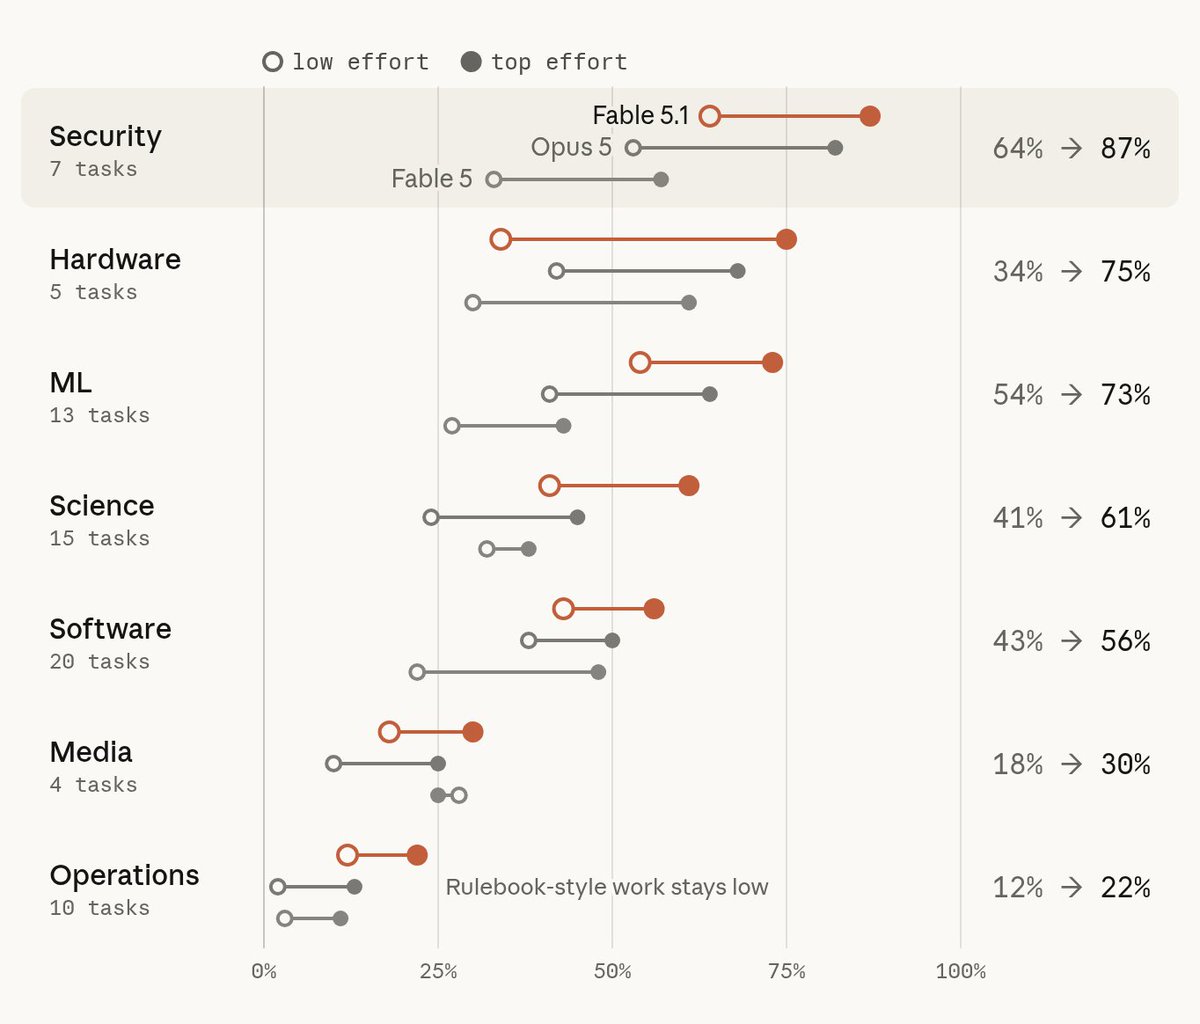
为说明这一点,我从 Terminal Bench 3.0 的不同领域选了几道题:Opus 5.5 在低投入下失败,却在高投入下成功——大多是因为它测试并考虑了边界情况:
mvcc-lsm-compaction:一道 Terminal-Bench 3.0 题目,要求根据 crash report 修复存储引擎 bug,同时不破坏 compaction。Opus 5.5 的成绩从低投入 0/5 提升到 xhigh 的 4/5。
低投入时(每次约 1 分钟),Claude 会在构建代码或运行复现程序前就编辑代码,也没有检查它新增的测试能否捕获原始 bug。
xhigh 时(约 11 分钟),Claude 先复现崩溃,针对永不 compacts 的参考实现写了随机化测试,并检查自己的测试能否让半成品修复失败。
cli-2ph-simple:一道 Terminal-Bench 3.0 题目,要求用 Python 编写一个 CLI 线性规划求解器。Opus 5.5 的成绩从低投入 0/5 提升到高投入 5/5。
低投入尝试一次性写出求解器,用几个小问题检查后就在约 10k tokens 时停止。最终消息里,Claude 警告它在大问题上可能很慢,但没有验证。
在高投入尝试中,Claude 先把求解器与独立的 brute-force solver 在随机问题上对照测试,再为更大的问题计时,遇到运行过久或崩溃的情况后重写了搜索策略。
gsea-proteomics:一道 Terminal-Bench 3.0 题目,要求在蛋白质组学数据上做 gene set enrichment analysis(GSEA),找出八种处理方案中哪些最接近目标组织。Opus 5.5 的成绩从低投入 0/5 提升到高投入 4/5。
低投入时,Claude 选择了一种听起来合理的数据预处理方法,以该方法运行分析并报告结果。
高投入时,Claude 尝试了两种数据预处理方法,发现显著处理方案列表发生变化,于是在选择正确方案前深入追查原因。
如果用户参与其中,Claude 可能会询问用户应如何设置问题;但在没有用户参与时,高投入做得更好。
在 Claude Code 中何时使用不同投入等级
以下是我关于各投入等级适用时机的经验法则:
- 低:希望快速响应、并保持自己参与时,例如头脑风暴、草图和简单修改。
- 中:大多数常规软件工程工作,例如新功能实现。
- 高:验证很重要或存在边界情况的工作,例如修复棕地代码库中的 bug。
- 最高:希望 Claude 完全自主解决困难问题时,例如端到端构建并验证应用、在关键软件中寻找安全漏洞。
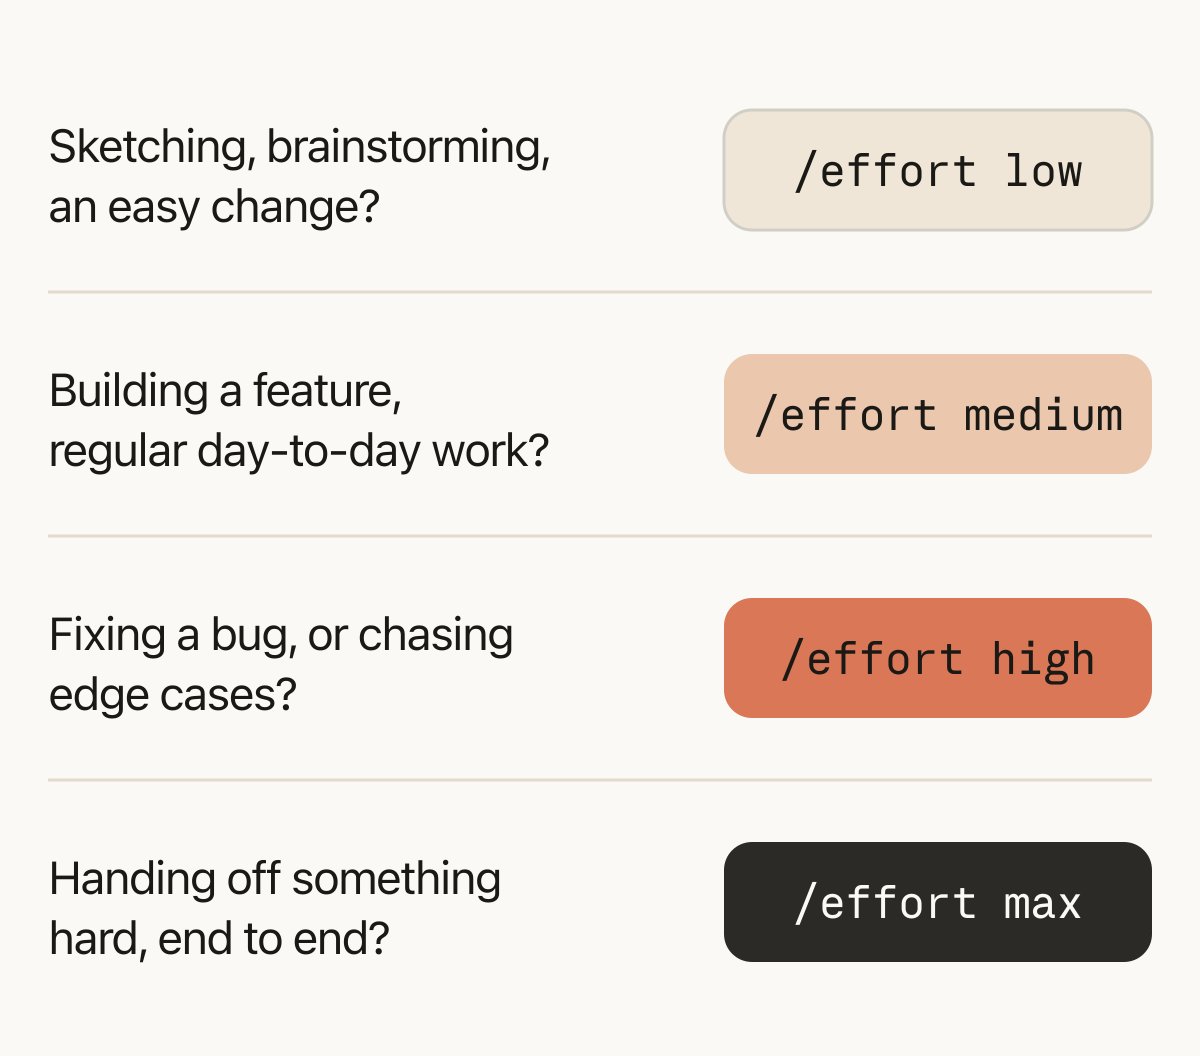
请根据任务为 Opus 5.5 和 Fable 5.1 调整投入强度;甚至可以在对话中通过 Claude Code 的 /effort 命令随时调整。也欢迎告诉我,这是否符合你的直觉。