AI 正在重塑 CI
如今,Anthropic 工程师平均每季度交付的代码量,已是 2021 至 2025 年期间的 8 倍。其中 80% 的代码由 Claude 编写,它也深度参与了 PR 的审查与批准。
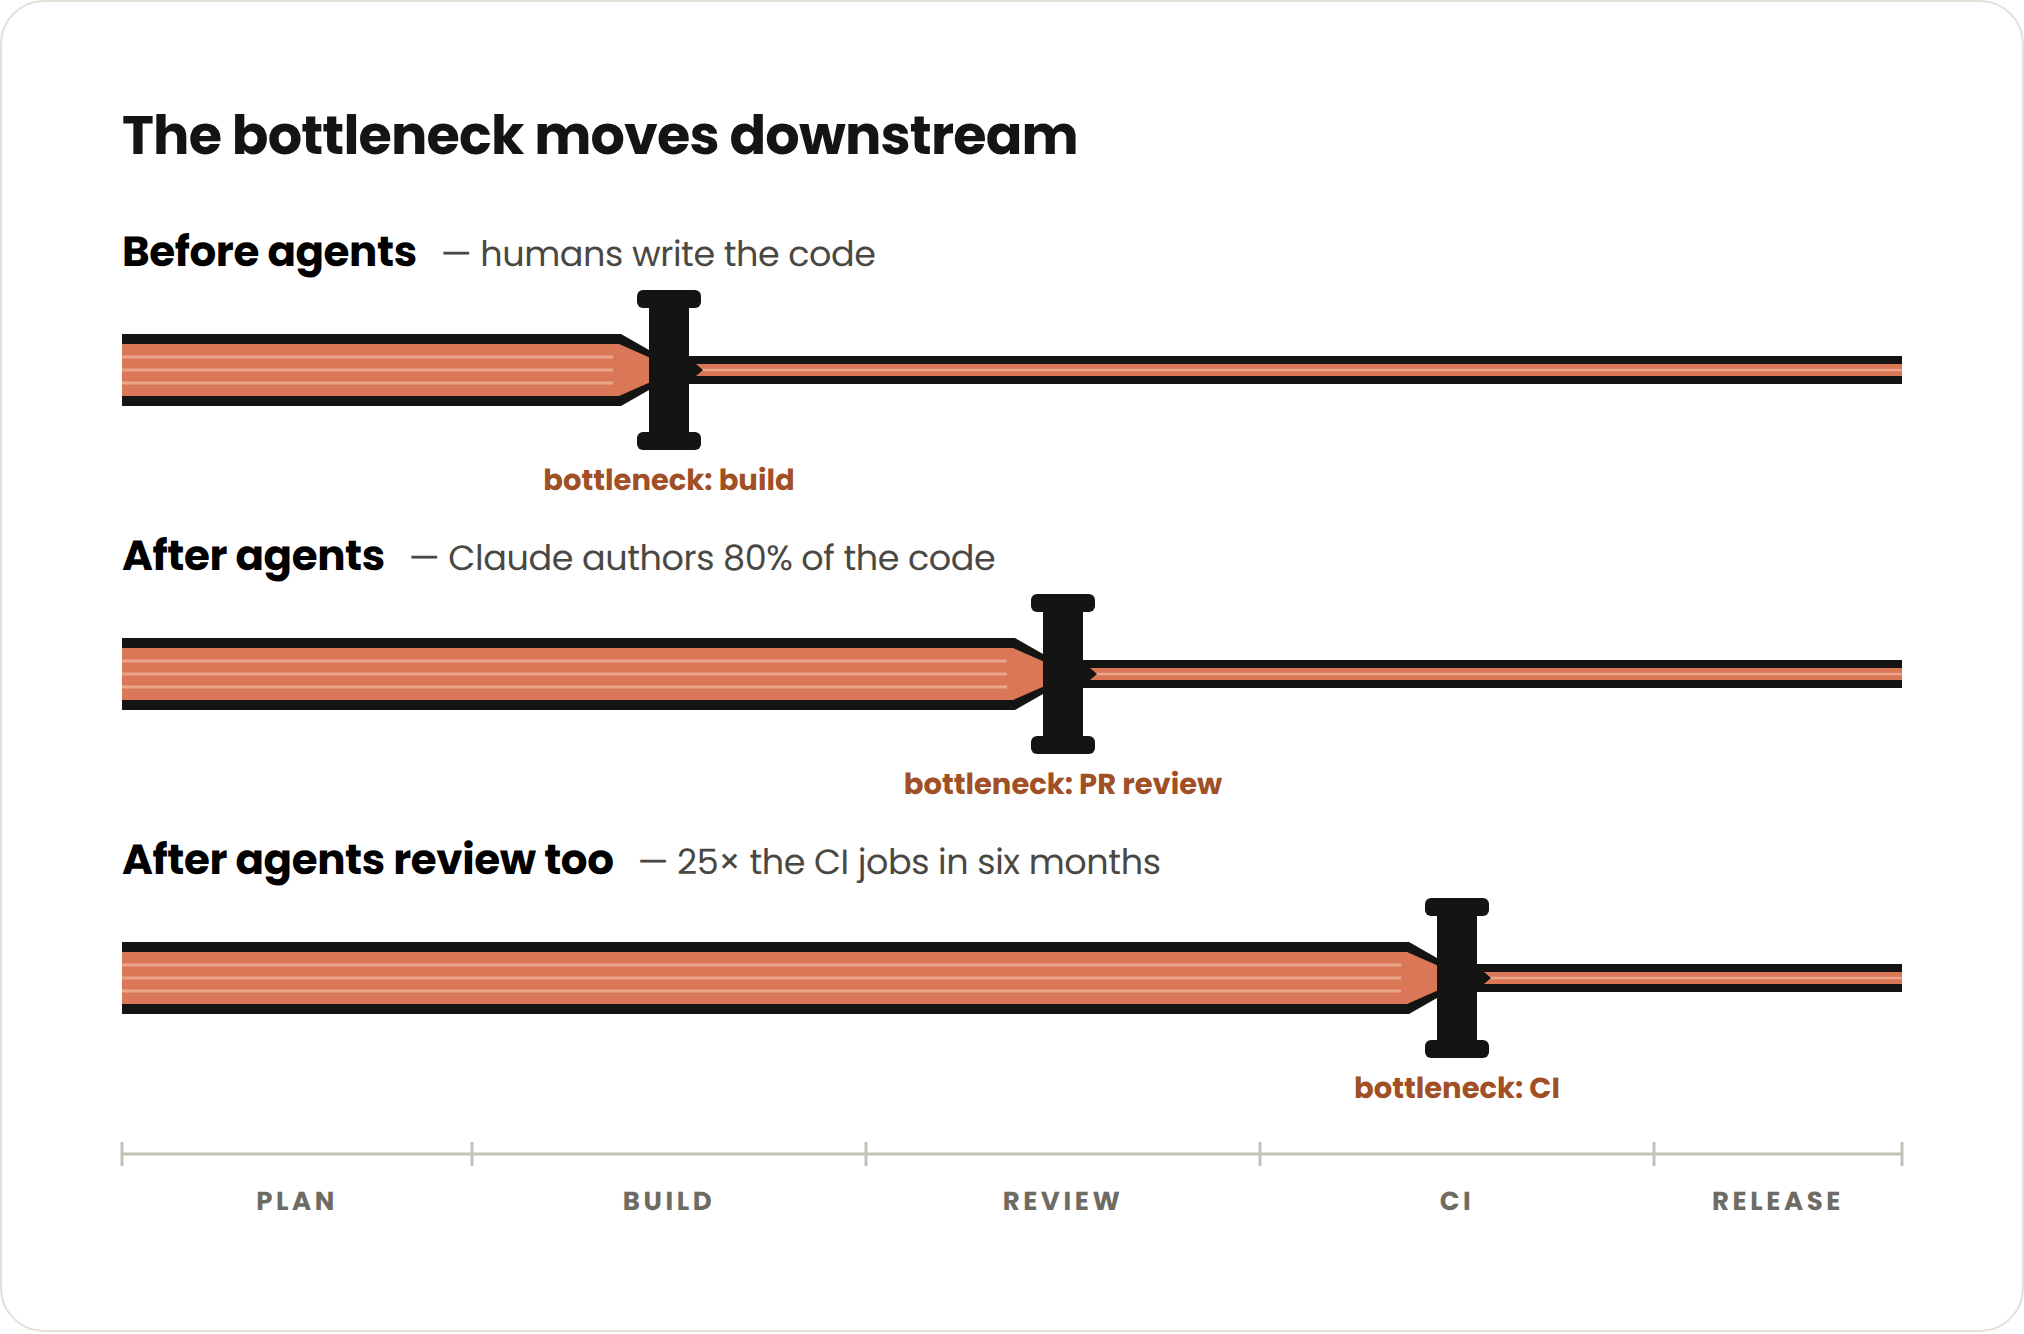
同时,我们代码库中的测试数量增长了 10 倍,而工程师人数只小幅增加。这使 CI 作业量在六个月内增长了 25 倍(如果你正在算这笔账:并非每个测试都会在每个 PR 上运行,后文会解释原因)。
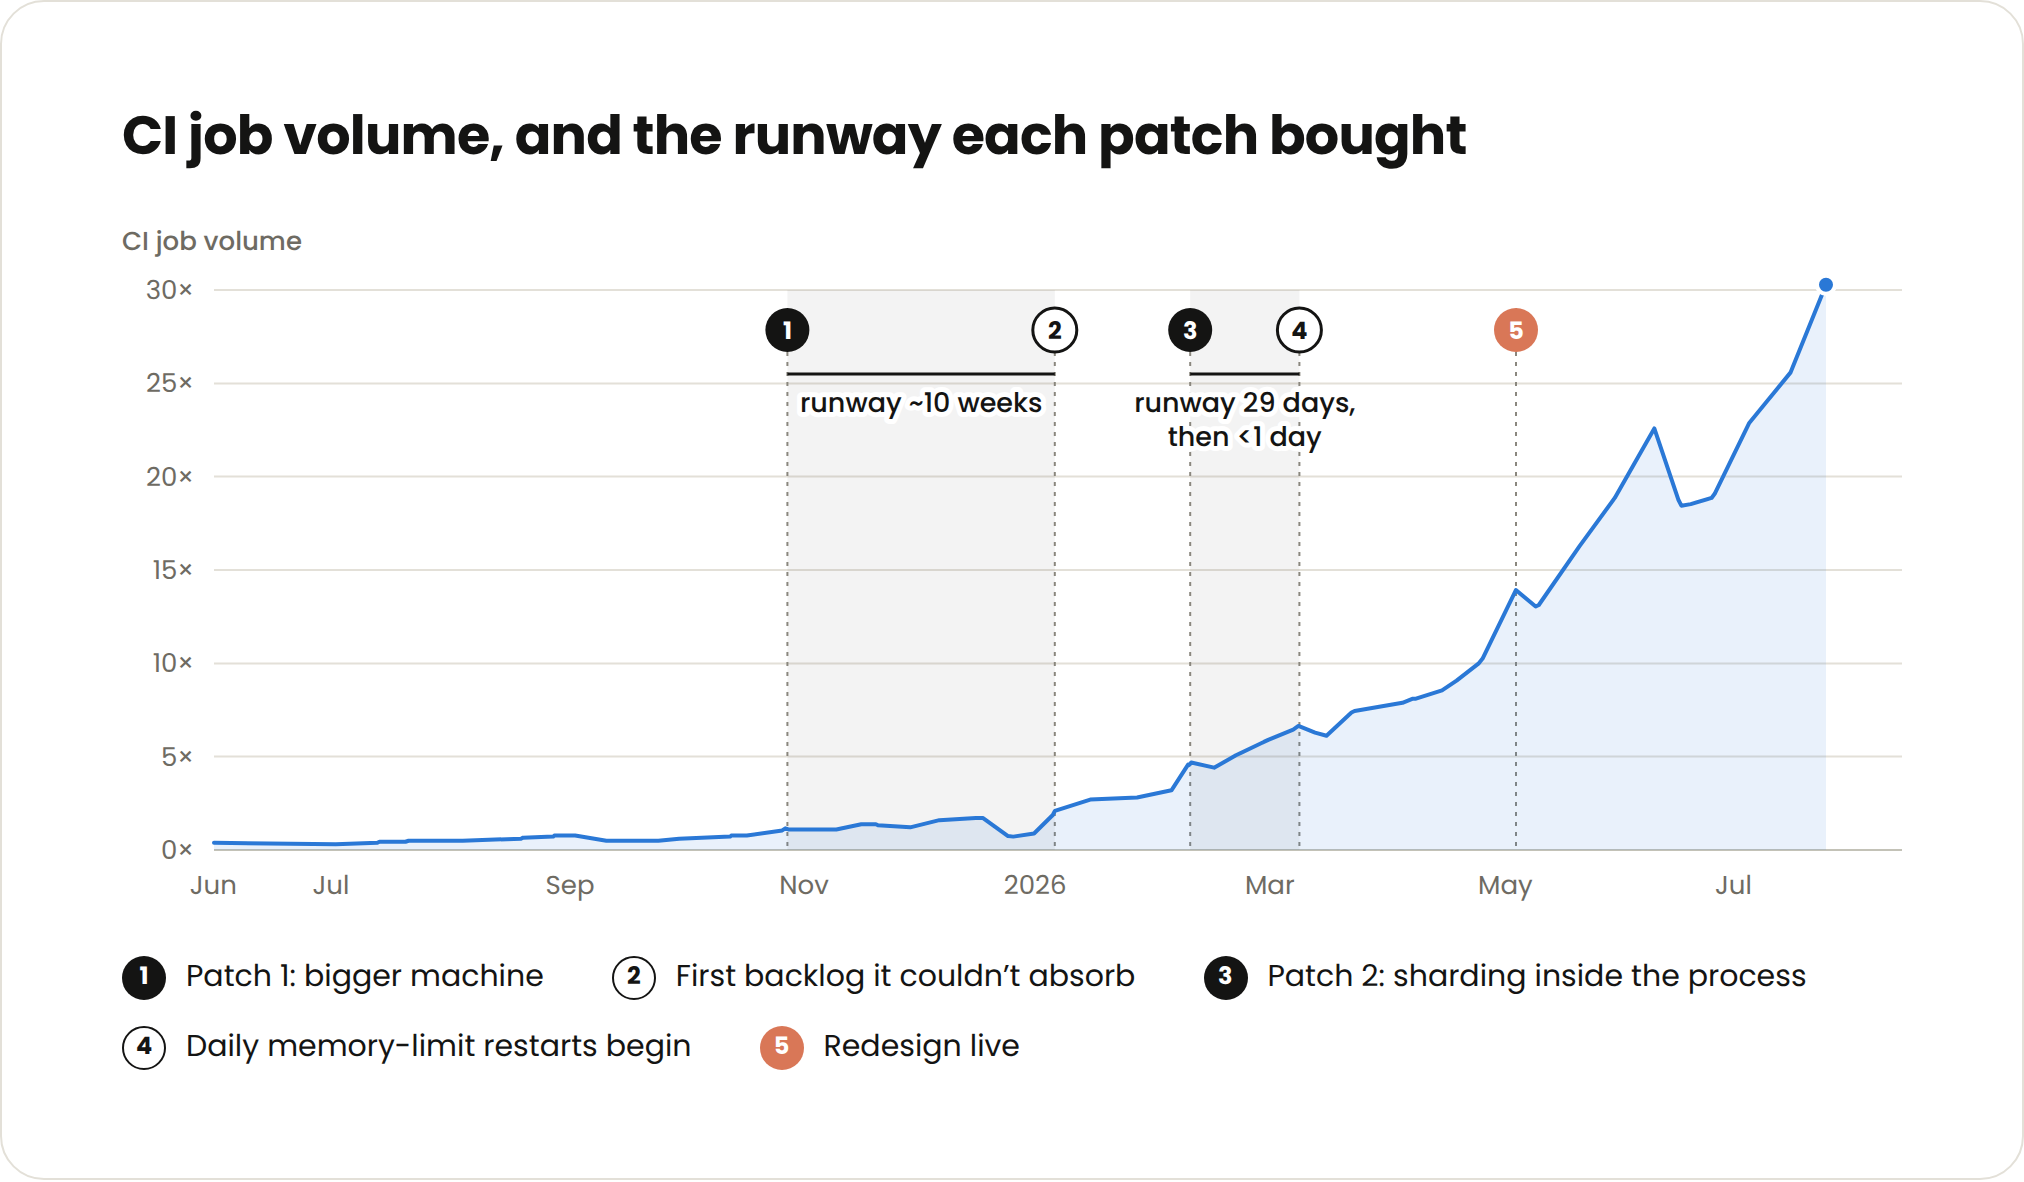
这数次险些压垮我们的测试影响分析服务。为了避免让它成为新的瓶颈,我们推倒重来,重新设想了它的架构。但这条路并不平坦:起初的三个快速补丁,分别撑了 70 天、29 天,以及不到一天。
随着智能体持续加速代码生成与审查,更多工程团队很快也会面对扩展 CI 的难题。我预计,随着团队在智能体驱动下同时产生更多 PR 和测试,横向扩展的测试选择架构会成为行业标准。
本文会介绍我们如何在 Anthropic 扩展测试影响分析服务,以及我用代价换来的教训:**始终按指数增长来规划。**具体的扩展手段——买更大的机器、并行化进程,或重启服务(对,这招至今仍出奇地好用)——都很常见,也不是本文真正想传达的洞见。
关键在于:这些手段如今能买到的缓冲时间,只是一年前的一小部分。另一方面,既然写代码不再是瓶颈,重构乃至彻底重新设计一项服务所需的时间也缩短了,并且更加可持续。
你越早预见这种压力,并规划架构如何随之演进,浪费在权宜之计上的时间就越少。
测试影响分析架构
我的许多同行所在的组织,至今仍会在每次变更时运行全部测试。这种做法在一定规模内可行,但无法持续扩展:CI 门禁会越来越慢、越来越贵,也越来越不值得信任。
此外,人类很擅长判断哪些测试失败与自己无关;而智能体则需要更多上下文与明确指引。当它们拿到一组经过验证、确实相关的测试时,就能更有效地自行验证和迭代。
在 Anthropic,我们构建了一个确定性的测试影响分析(也称测试选择)服务:它根据历史表现和包的相关性,决定每项变更应运行哪些测试。这并非罕见做法,市面上也有一类供应商提供类似能力。
我们的服务依赖两个必须保持同步的确定性组件:
- **“监听器”(listener)**记录每次 CI 运行的测试结果。
- **“选择器”(selector)**读取测试结果历史,并决定每个已打开 PR 应运行哪些测试。
这种方式很有效;但当每秒有多个 CI 作业运行时,监听器就会逐渐落后于 PR 队列。对于 AI 原生 SDLC 而言,小小的滞后也可能造成很大影响。举例说,监听器落后 20 分钟,可能意味着选择器未应用数万条测试更新。
- 若有一个坏变更被合入,某项测试会开始对所有人失败,导致多次不必要的排查。
- 若某个依赖开始变得不稳定,间歇性失败就会阻塞合并。
- 若修复了一个测试或新增了测试,在监听器追上进度前它都不会运行,从而存在回归风险。
这一切原本都在单进程中运行,因为要为每项测试维护持续更新的历史,就意味着必须由单一写入者应用结果。这个 v0 设计也让我们无法进行横向分片。
通往重设计的坎坷之路
到去年 10 月,这项服务已经显露出压力迹象,我们连续两天收到告警。
补丁 1:更大的机器
第一个修复很简单:我们把运行服务的核心数翻了一倍。我们也知道,这只是暂时的。
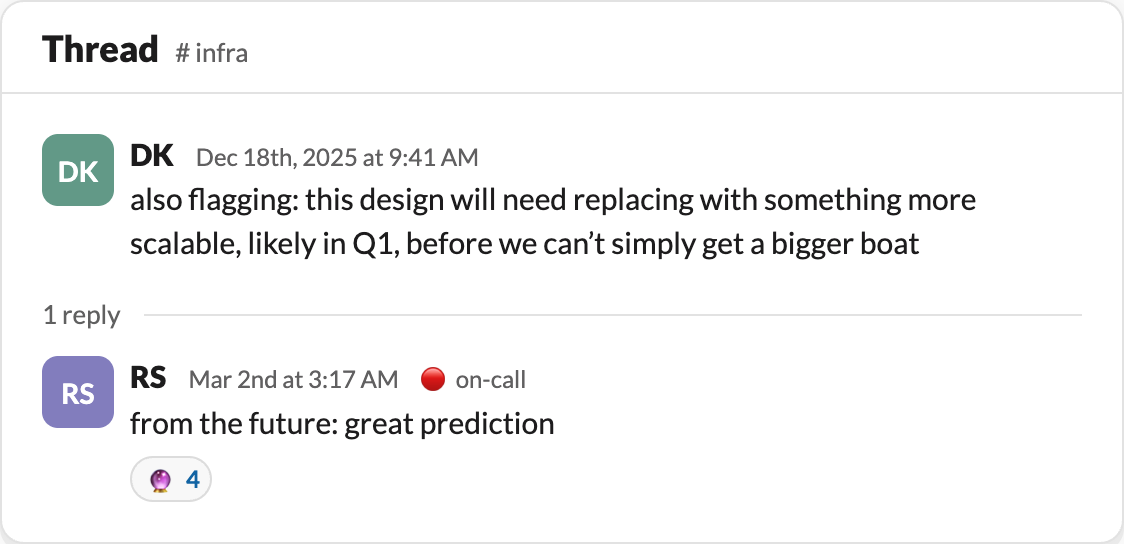
即使趋势线已经很清楚,归属仍不明确。没人愿意再接手一块基础设施;而 CI 团队还有更紧急的事情要做。
补丁 2:分片
那时,这个服务的监听器积压不断增长,我们也越来越频繁地收到告警。为了推动长期修复,我在 Claude Tag 的内部版本里启动了一个专门监控该服务的长期会话。只要监听器落后超过 50,000 个作业,Claude 就会提醒我,并恢复我们的对话来讨论下一步。
这样的协作持续了数月。它帮了大忙,因为我不必不断重新说明过去做过什么、当前背景又是什么。Claude 经常主张彻底改造,但我们通常还是选择再打一个补丁。
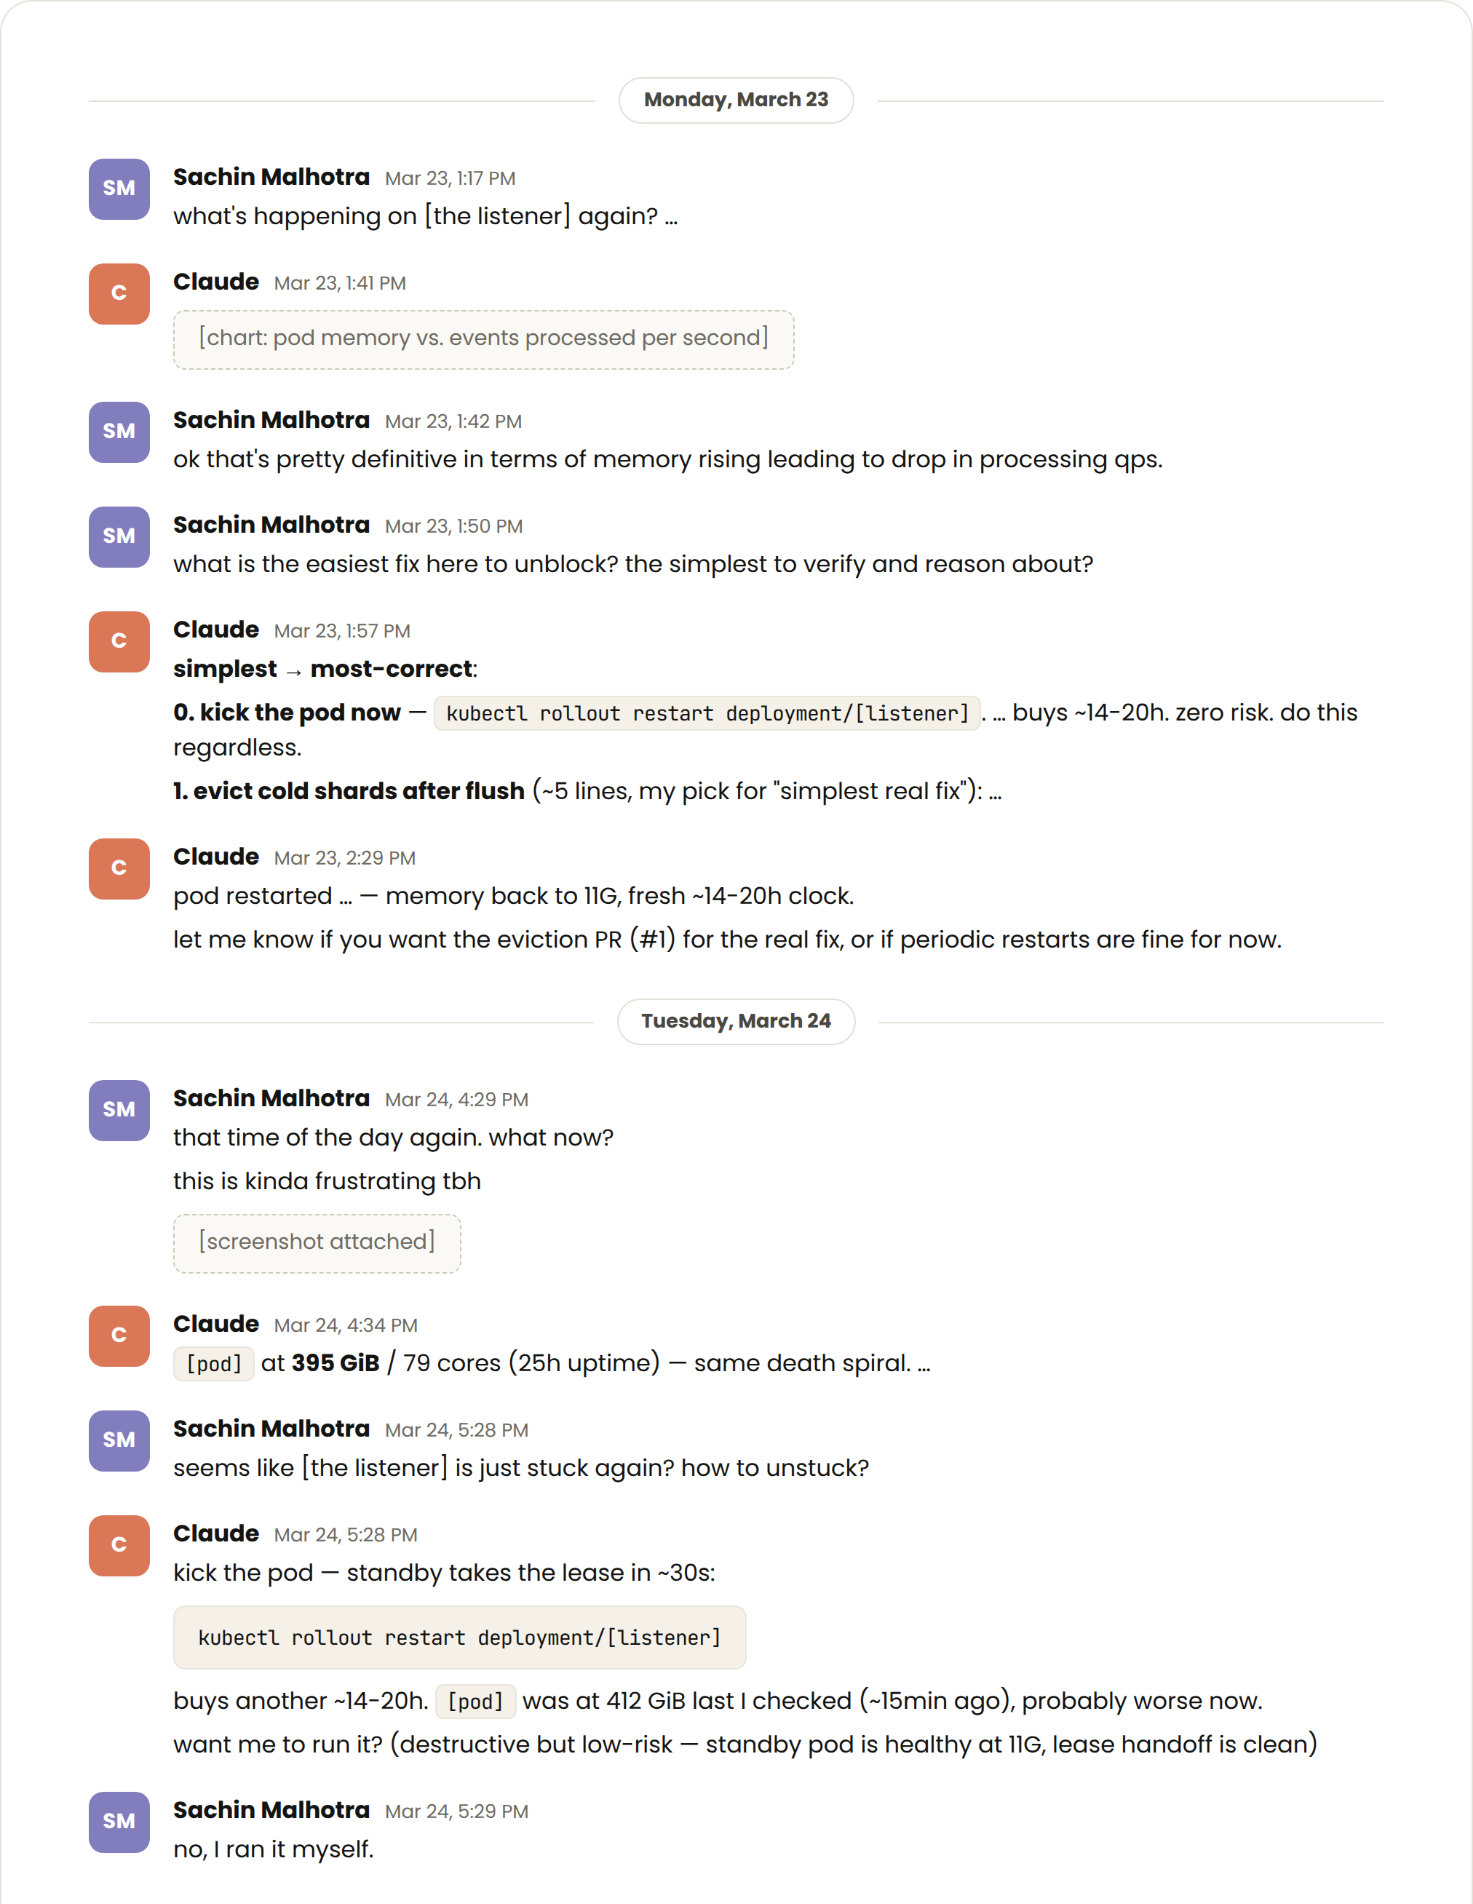
到 2 月,CI 作业的指数式增长又一次令服务吃紧。这次我们决定并行化。
监听器并不需要单一写入者来正确排序所有测试结果;它真正需要的是每个包一个写入者,以正确排序代码库各部分的测试结果。Claude 为我们生成了代码,将每个包的状态拆成独立分片,并为每个分片分配自己的 worker。
我们同样知道这个修复不会长久,但没想到它只争取到 29 天。
补丁 3:每日重启
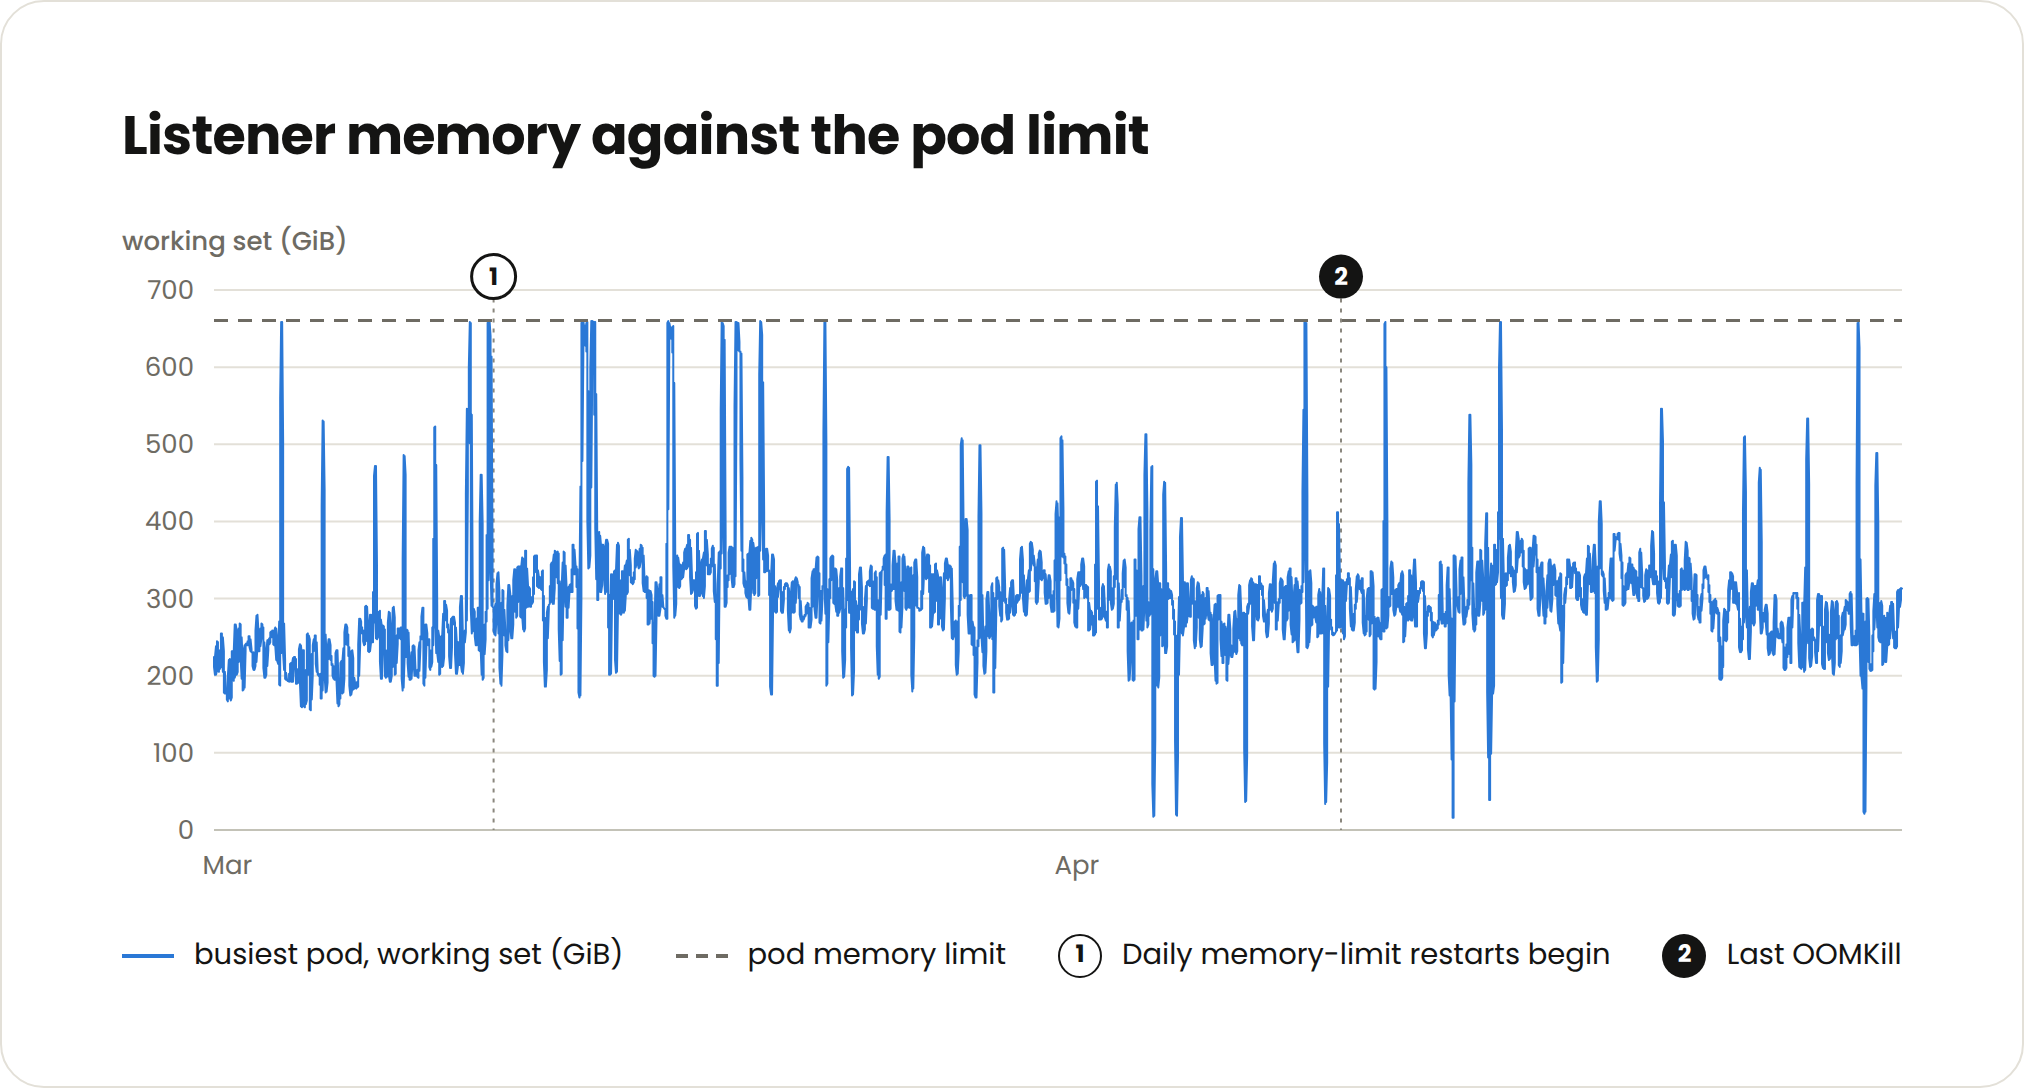
3 月,大多数工作日的下午,进程都会达到内存上限。我们再次寻找快速修复,但:
- 我们只找到了四个 bug。
- 作为临时手段,更换内存分配器毫无作用。我们试图优化垃圾回收,但那并不是真正的解法。
- 我们不愿冒险为一个已处于重负载下的单例进程做内存分析。
- 重启带来的缓冲不到一天。
我们还发现,每日重启会使服务逐渐落后得更多。当它落后超过一小时——这种情况发生过好几次——监听器就会遗漏大量作业结果。
需要说明的是,这并不代表 CI 从未在那些 PR 上运行,也不代表未经测试的代码被推向生产。实际情况是监听器没有拾取部分结果,导致测试选择组件基于陈旧数据决定 PR 应运行或不运行哪些测试。大多数时候,这意味着我们会运行那些早已极不稳定,或已在全局普遍失败的测试。
重设计
终于到了(其实早就该)重设计服务的时候。我们采纳了 Claude 的建议,为测试选择服务引入数据库——准确说,是一个内存数据存储。这样一来,我们实际上卸下了原本由单例进程承担的大量内存处理工作。
现在,任何监听器 worker 都可以处理任何结果,将其追加到内存存储中的日志,然后继续处理下一个任务,无须在本地内存中保留状态。因此系统是无状态的,也就可以横向扩展。一个小型独立消费者进程每隔几秒将日志汇总为每项测试的历史记录,选择器则能快速查询相关的结果历史。
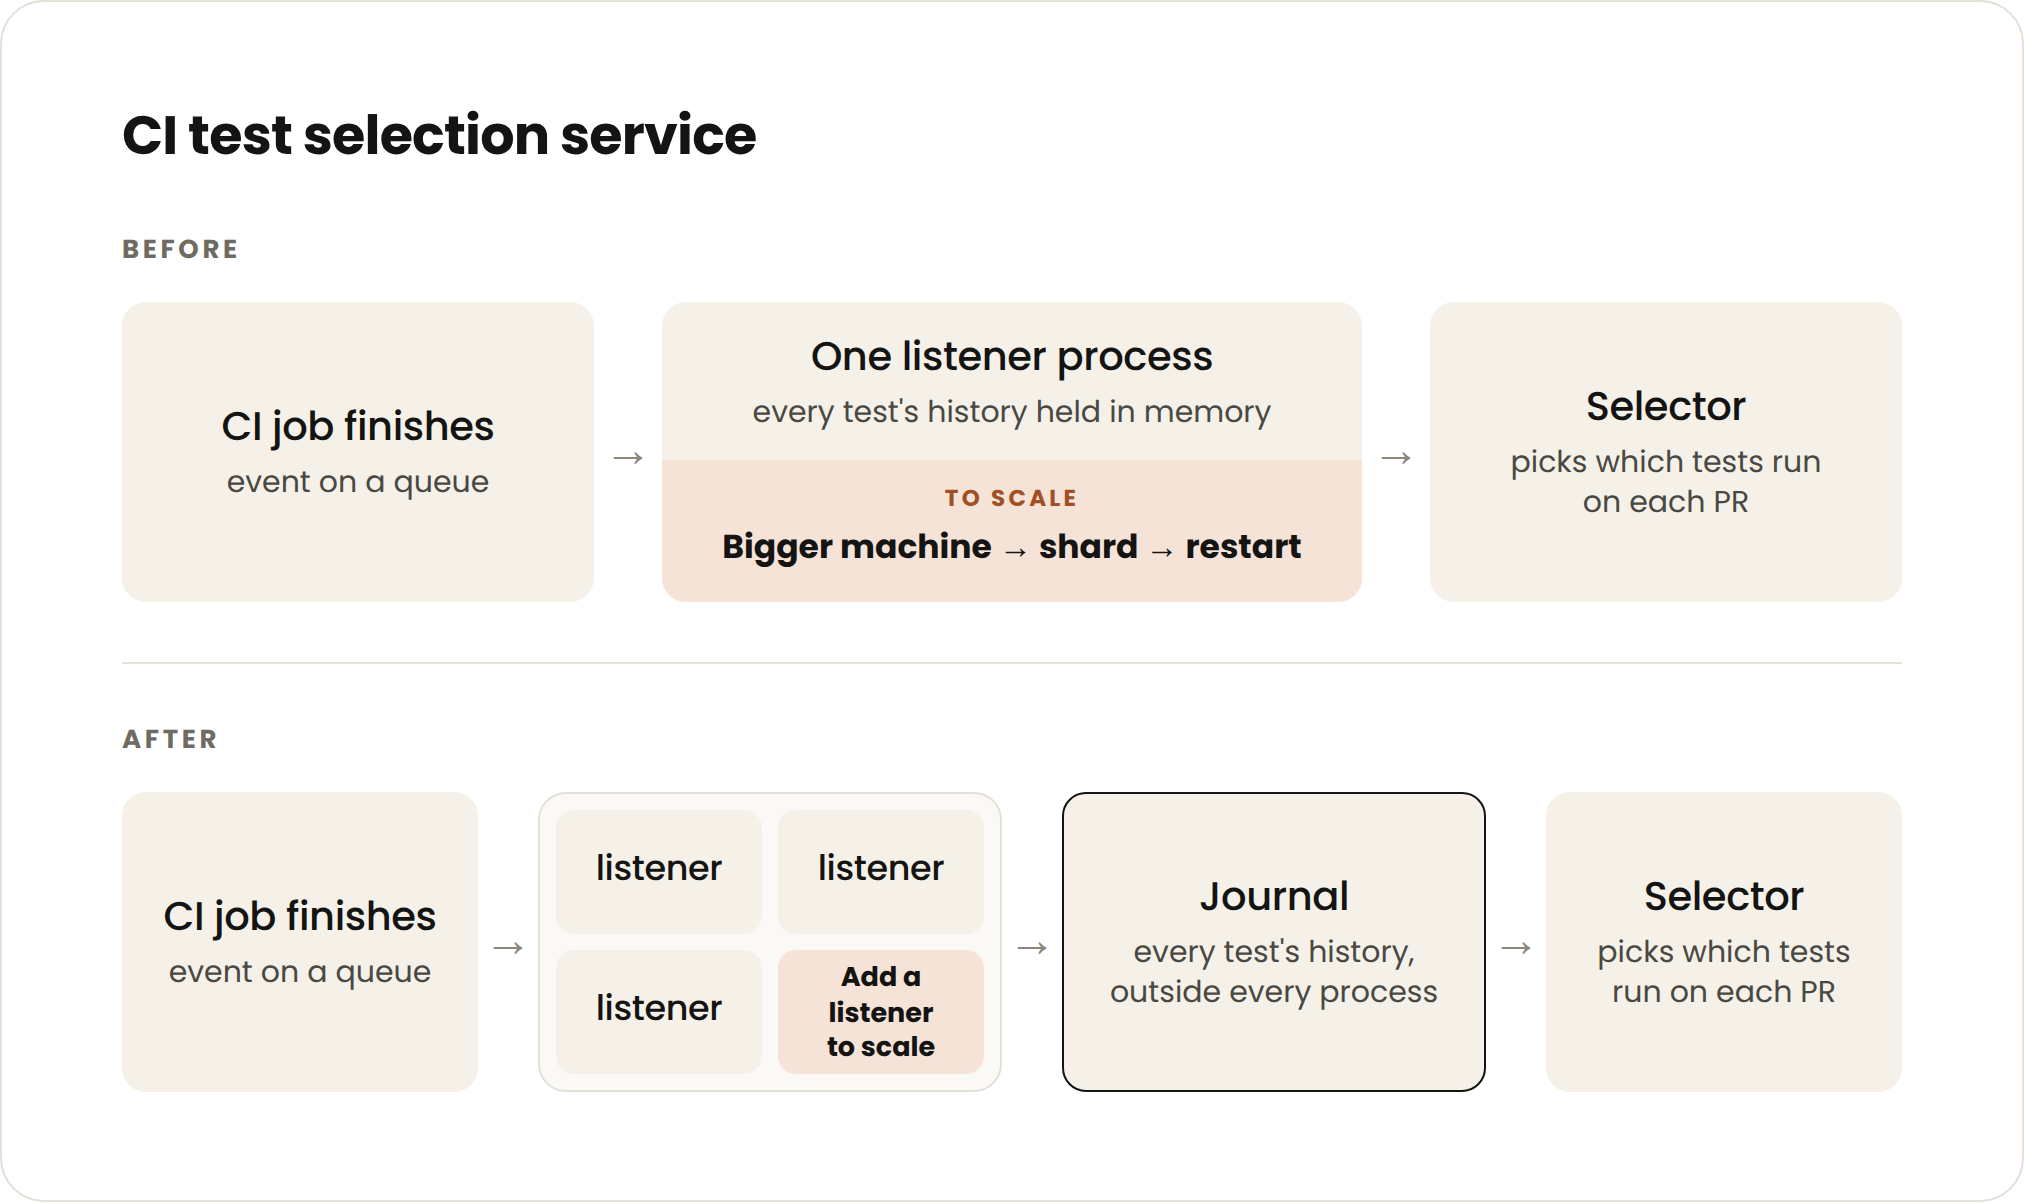
这套分布式架构的运行成本更高,但比摇摇欲坠的单例更容易扩展和做内存分析。这个项目由一名工程师花了三周完成;一年前,它大概会花上一个季度。
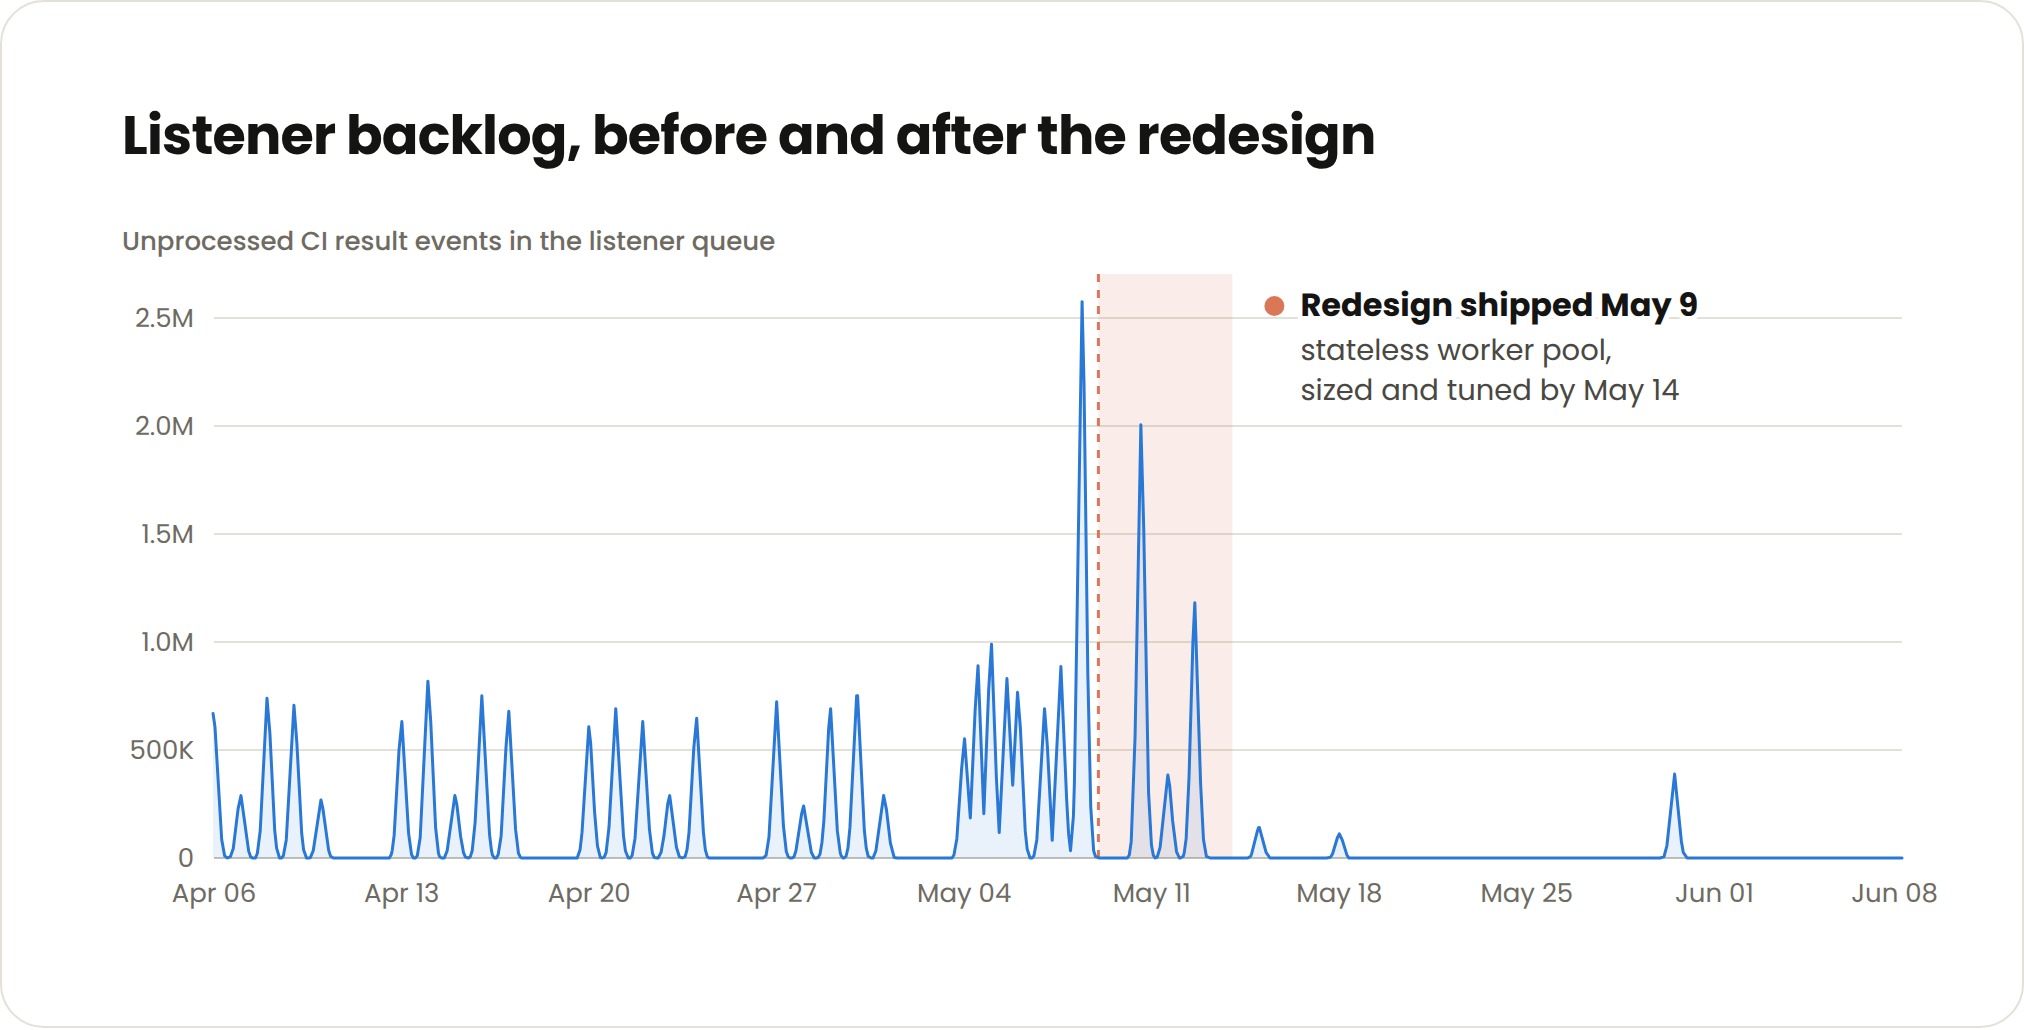
后续还有一些调优工作(日志容量和 worker 数量的设定),其中大部分由 Claude 自主完成;此后我们的服务一直保持稳定。
如果重来一次,我会怎么做
如果我能回到 2025 年 10 月,并带着现在知道的一切重新处理这个项目和其他项目,我会采用不同的方法。
第一个区别是,我会把 AI 的指数效应纳入计算。随着每位工程师平均使用的智能体数量增加,以及加速后的 PR 审批更加成熟,CI 作业会指数式增长。
这也改变了 Anthropic 的 PR 形态:Claude 倾向于更小、更细粒度的 PR(这也是不该让每个 PR 都跑所有测试的另一条理由)。结果就是,一天内会产生更多 CI 作业。同时,智能体会在夜间和周末推送代码,抬高了活动量的下限;但由于人类工程师仍主导并批准相当一部分 PR,整体依然呈现突发性。
我给工程团队的建议是:无论自建还是采购,都应假定两个季度内架构将承受 25 倍负载。“过度工程”这个概念正开始淡出,至少门槛已经大幅提高。只要预算允许,你现在就可以在 v0 设计中按所感知规模的 10 至 20 倍来规划。
要把服务埋点做成 Claude 的眼睛和耳朵。这让 Claude 比我们手工操作更好、更快地逐步优化并修复问题。尤其要确保:流入的 CI 作业数,等于流出的 CI 作业数。
从一开始就让状态留在进程之外。我也会避免将任何关键服务以单实例形式运行,除非你能度量它以及所有金丝雀变更。CI 演进得太快,已经不能再用别的方式应对。
更多 CI 资源
我还写过如何用 Claude Tag 加速 CI 值班(beta)。