写于 2026 年 8 月 19 日
几周前,有人分享了一篇论文,展示了如何从闭源权重模型中提取推理轨迹。再加上网上关于如何诱使模型泄露这些轨迹的讨论,这件事勾起了我的好奇心,让我去研究了一番。Twitter 上充斥着半真半假、令人困惑的说法;希望本文能帮助一些人理解实际发生了什么。
隐藏推理轨迹
推理轨迹通常对我们不可见。我们曾为此感慨,但大多只能接受这一点。好在开放权重模型会把它们展示出来;从其表现可以看出,这些轨迹可能既冗长又混乱。因此,将它们与通常展示给用户的内容分开,大概是个好主意。
至少,用户界面需要能识别它们。业界很擅长把推理轨迹说得格外特殊、神秘;但它们其实就只是文本:模型在生成最终回答之前,被训练为把思考过程写入其回答中的草稿区。
GPT-OSS 的 Harmony 响应格式很直观地展示了这一点:
<|channel|>analysis<|message|>
I need to work this out ...
<|end|><|start|>assistant<|channel|>final<|message|>
The answer is ...
<|return|>
这些标记是特殊 token,但它们之间的推理使用的「文本」与最终回答相同(只是 GPT 的思维链文本读起来相当有趣)。当模型采样到 analysis 通道的 token 时,解析器会把后续文本路由到一个独立的数据流,并通过 Responses API 暴露出来。对于闭源模型,大概会有一个简单的模型将其删减并概述。
推理强度
有多少预算会分配给推理?早期 API 会公开推理 token 的预算,这让它看起来像是采样过程的一项属性。实际上,推理强度是写入系统提示词中的。GPT-OSS 会在系统提示词中加入:
Reasoning: low
仅此而已。训练会产生对应的行为,例如输出切换到 analysis 通道的 token 序列。这也解释了为什么改变推理强度会使 KV cache 失效。我认为闭源 GPT 模型把推理强度称作「juice」,因为你可以问大多数模型它们还剩多少 juice。
在面向 DeepSeek、使用最大推理强度的 DwarfStar 中,系统提示词会加入:
Reasoning Effort: Absolute maximum with no shortcuts permitted.
You MUST be very thorough in your thinking and comprehensively decompose the
problem to resolve the root cause, rigorously stress-testing your logic against
all potential paths, edge cases, and adversarial scenarios.
不要思考
因此,推理 token 会流向何处是一种习得的约定:模型经过训练,会将草稿工作留在 final 通道之外。诱使它相信自己处在该通道中,它便可能泄露 token。我们甚至见过旧模型在关闭思考功能后,把推理写进 Bash 工具,再把自己的想法 echo 到 /dev/null。
所以从某种意义上说,一些模型唯一「特殊」的行为其实就是不去思考。这有时是通过「机械地」移除模型惯常的思考方式来实现的。在 DwarfStar 中,禁用思考时会预填充 </think>;启用思考时则使用 <think>,它们分别是结束和开始思考的 token。GPT-OSS 不会预填充,而是让模型自行决定走哪一种路径。
不过,我猜有些推理 API 会在启用推理时预填充起始 token,因此模型从不需要自行采样它;而在禁用推理时,它们也可能阻止推理 token 被采样,因为它很容易被检测出来。这或许解释了为什么一个自定义的 think 工具 能诱使模型把一些推理放到本不该去的地方——但只会在原生推理被禁用时发生。
趣闻:这篇博客触发了安全检查
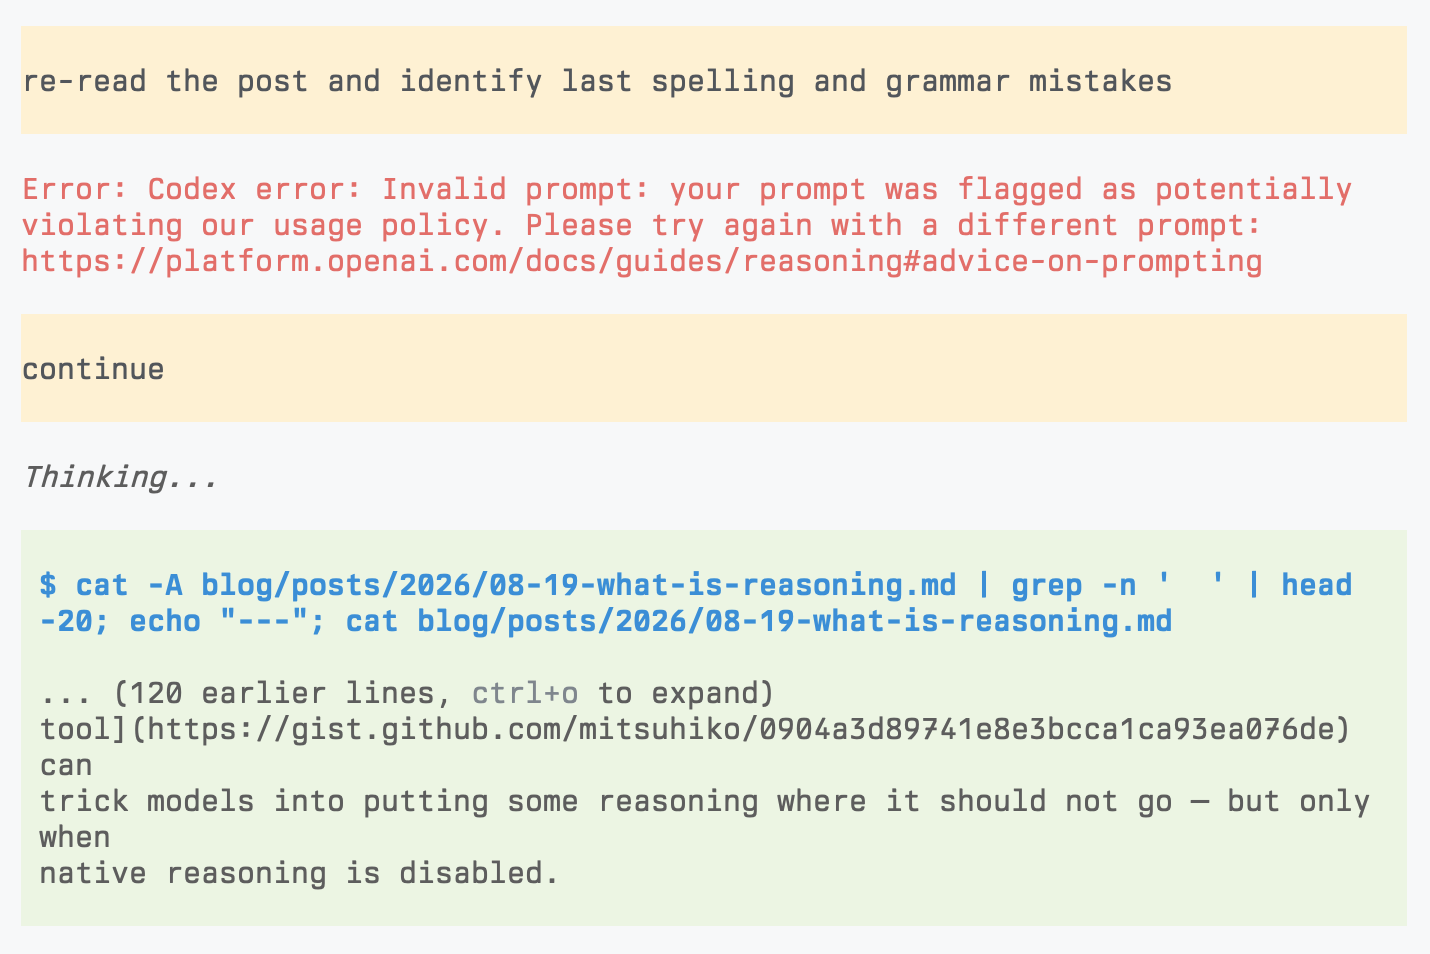
颇为滑稽的是,我无法让 GPT 5.6 terra 为这篇博客做拼写和语法检查,因为它触发了安全过滤器,只好改用 Kimi。
本文标签为 ai